第1章 MySQL数据库概述
1 为什么要用数据库?
- 数据库是什么?
- 集合存储和管理数据的地方
- DB:数据库(Database)
- 为什么要用数据库?
- 集中存储和管理
- 按照一定的结构组织和管理,便于检索和维护
- 数据的持久化?
- 数据存储在内存中,虽然效率更高,但是一旦程序崩溃或断电,数据就会丢失
- 将数据写到可掉电式设备中,通常按一定格式写到文件中
- 用普通文件存储行不行?
- 把数据写入到硬盘上的文件中,当然可以实现持久化的目标,但是不利于后期的检索和管理等。
- MySQL、Oracle、SqlServer是什么?
- MySQL、Oracle、SqlServer都是数据库管理系统(DBMS,Database Management System)是一种操纵和管理数据库的大型软件,例如建立、使用和维护数据库。
2 MySQL数据库管理系统
在互联网行业,MySQL数据库毫无疑问已经是最常用的数据库。MySQL数据库由瑞典MySQL AB公司开发。公司名中的“AB”是瑞典语“aktiebolag”股份公司的首字母缩写。该公司于2008年1月16号被Sun(Stanford University Network)公司收购。然而2009年,SUN公司又被Oracle收购。因此,MySQL数据库现在隶属于Oracle(甲骨文)公司。MySQL中的“My”是其发明者(Michael Widenius,通常称为Monty)根据其女儿的名字来命名的。对这位发明者来说,MySQL数据库就仿佛是他可爱的女儿。
MySQL的优点有很多,其中主要的优势有如下几点:
- 免费:MySQL的社区版完全免费,一般中小型网站的开发都选择 MySQL 作为网站数据库。
- 可移植性:MySQL数据库几乎支持所有的操作系统,如Linux、Solaris、FreeBSD、Mac和Windows。
- 开源:2000 年,MySQL公布了自己的源代码,并采用GPL(GNU General Public License)许可协议,正式进入开源的世界。开源意味着可以让更多人审阅和贡献源代码,可以吸纳更多优秀人才的代码成果。
- 关系型数据库:MySQL可以利用标准SQL语法进行查询和操作。
- 速度快、体积小、容易使用:与其他大型数据库的设置和管理相比,其复杂程度较低,易于学习。MySQL的早期版本(主要使用的是MyISAM引擎)在高并发下显得有些力不从心,随着版本的升级优化(主要使用的是InnoDB引擎),在实践中也证明了高压力下的可用性。从2009年开始,阿里的“去IOE”备受关注,淘宝DBA团队再次从Oracle转向MySQL,其他使用MySQL数据库的公司还有Facebook、Twitter、YouTube、百度、腾讯、去哪儿、魅族等等,自此,MySQL在市场上占据了很大的份额。
- 安全性和连接性:十分灵活和安全的权限和密码系统,允许基于主机的验证。连接到服务器时,所有的密码传输均采用加密形式,从而保证了密码安全。由于MySQL是网络化的,因此可以在因特网上的任何地方访问,提高数据共享的效率。
- 丰富的接口:提供了用于C、C++、Java、PHP、Python、Ruby和Eiffel、Perl等语言的API。
- 灵活:MySQL并不完美,但是却足够灵活,能够适应高要求的环境。同时,MySQL既可以嵌入到应用程序中,也可以支持数据仓库、内容索引和部署软件、高可用的冗余系统、在线事务处理系统等各种应用类型。
- MySQL最重要、最与众不同的特性是它的存储引擎架构,这种架构的设计将查询处理(Query Processing)及其他系统任务(Server Task)和数据的存储/提取相分离。这种处理和存储分离的设计可以在使用时根据性能、特性,以及其他需求来选择数据存储的方式。MySQL中同一个数据库,不同的表格可以选择不同的存储引擎。其中使用最多的是InnoDB 和MyISAM,MySQL5.5之后InnoDB是默认的存储引擎。
针对不同用户,MySQL提供三个不同的版本。
(1)MySQL Enterprise Server(企业版):能够以更高的性价比为企业提供数据仓库应用,该版本需要付费使用,官方提供电话技术支持。
(2)MySQL Cluster(集群版):MySQL 集群是 MySQL 适合于分布式计算环境的高可用、高冗余版本。它采用了 NDB Cluster 存储引擎,允许在 1 个集群中运行多个 MySQL 服务器。它不能单独使用,需要在社区版或企业版基础上使用。
(3)MySQL Community Server(社区版):在开源GPL许可证之下可以自由的使用。该版本完全免费,但是官方不提供技术支持。本书是基于社区版讲解和演示的。在MySQL 社区版开发过程中,同时存在多个发布系列,每个发布处在不同的成熟阶段。
- MySQL5.7(RC)是当前稳定的发布系列。RC(Release Candidate候选版本)版只针对严重漏洞修复和安全修复重新发布,没有增加会影响该系列的重要功能。从MySQL 5.0、5.1、5.5、5.6直到5.7都基于5这个大版本,升级的小版本。5.0版本中加入了存储过程、服务器端游标、触发器、视图、分布式事务、查询优化器的显著改进以及其他的一些特性。这也为MySQL 5.0之后的版本迈向高性能数据库的发展奠定了基础。
- MySQL8.0.26(GA)是最新开发的稳定发布系列。GA(General Availability正式发布的版本)是包含新功能的正式发布版本。这个版本是MySQL数据库又一个开拓时代的开始。
3 关系型数据库和非关系型数据库
以下是2021年《DB-Engines Ranking》对各数据库受欢迎程度进行调查后的统计结果(查看数据库最新排名:https://db-engines.com/en/ranking)
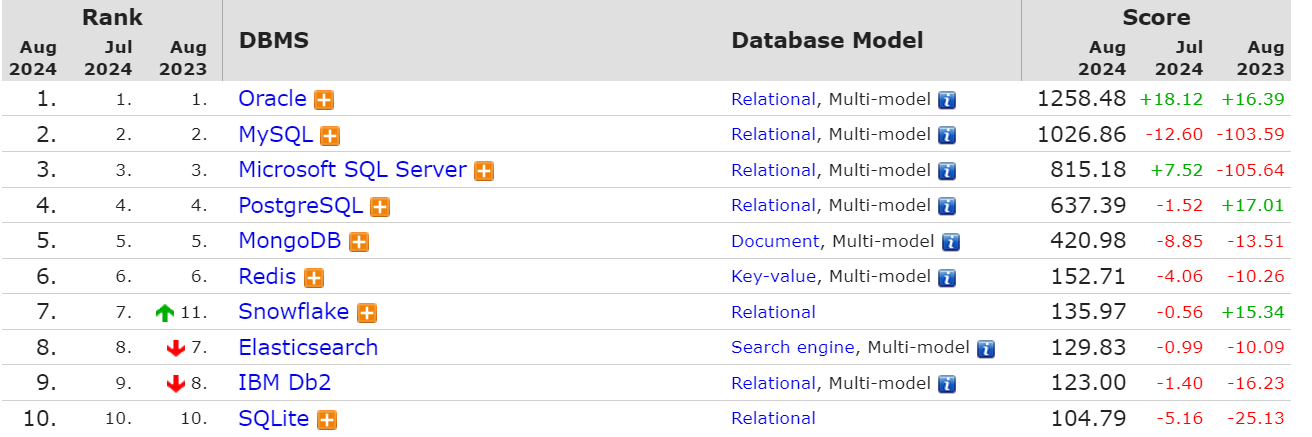
上面的数据库分为:关系型数据库和非关系数据库。
- MySQL、Oracle、SqlServer等是关系型数据库管理系统。
- MongoDB、Redis、Elasticsearch等是非关系型数据库管理系统。
3.1.关系型数据库
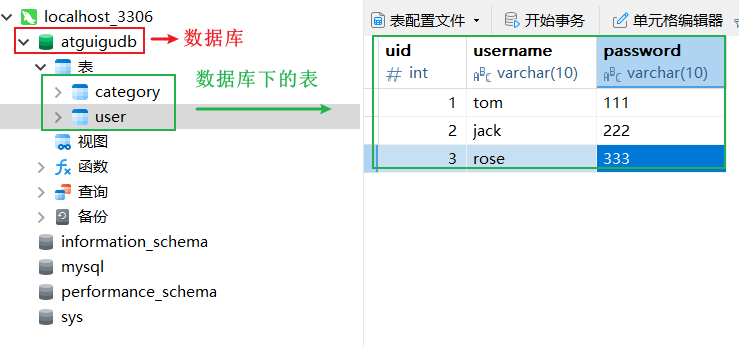
关系型数据库,采用关系模型来组织数据,简单来说,关系模型指的就是二维表格模型。类似于Excel工作表。
4 表的关系
在关系数据库管理系统中,很多表之间是有关系的,表之间的关系分为一对一关系、一对多关系和多对多关系。
4.1.一对一
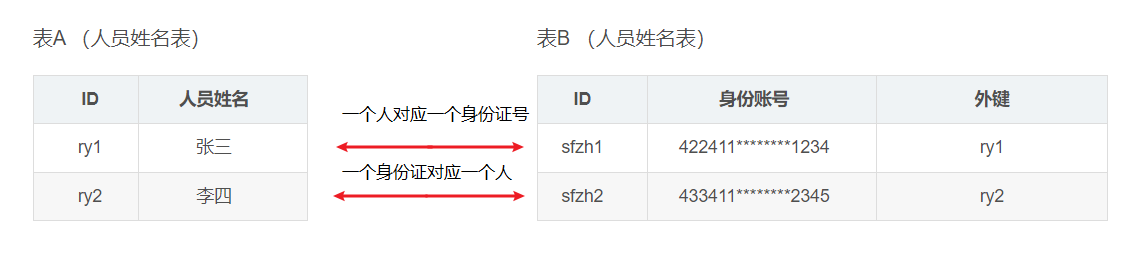
该关系中第一个表中的一个行只可以与第二个表中的一个行相关,且第二个表中的一个行也只可以与第一个表中的一个行相关。
例如,"人员信息表","身份证表",一个人只能有一个身份证号,反过来一个身份证号只能对应一个人
4.2.一对多
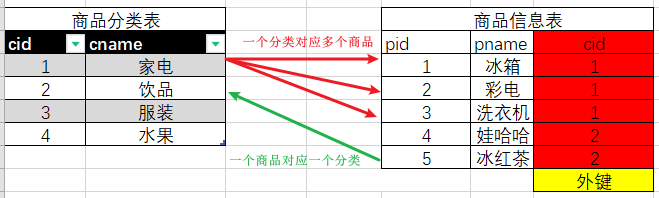
第一个表中的一个行可以与第二个表中的一个或多个行相关,但第二个表中的一个行只可以与第一个表中的一个行相关。
例如,“商品分类表”和“商品信息表”。一个商品分类对应多个商品,反过来一个商品只属于一个分类,形成了一对多
4.3.多对多
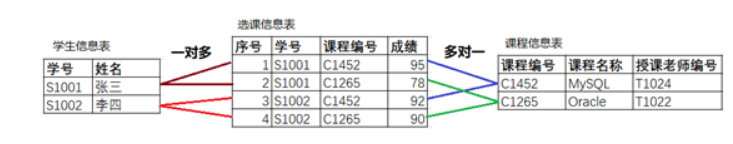
该关系中第一个表中的一个行可以与第二个表中的一个或多个行相关。第二个表中的一个行也可以与第一个表中的一个或多个行相关。通常两个表的多对多关系会借助第三张表,转换为两个一对多的关系。
例如,选课系统的“学生信息表”和“课程信息表”是多对多关系。一个学生可以选择多门课,一门课程可以被多个学生选择,即“学生信息表”中一条记录可以与“课程信息表”多条记录对应,反过来“课程信息表”的一条记录也可以与“学生信息表”中多条记录对应。它们之间借助第三张“选课信息表”实现关联关系,而“学生信息表”与“选课信息表”是一对多关系,“课程信息表”与“选课信息表”也是一对多关系。“选课信息表”中“学号”字段与“学生信息表”中“学号”字段意义相同。“课程信息表”中“课程编号”字段与“课程信息表”中“课程编号”字段意义相同。
第2章 SQL
2.1 什么是SQL
SQL:结构化查询语言,(Structure Query Language),专门用来操作/访问数据库的通用语言。
2.2 SQL演示
2.2.1 数据库
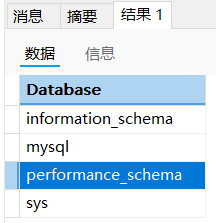
1、查看所有的数据库
show databases;
2、创建自己的数据库
create database 数据库名;

#创建atguigudb数据库
create database atguigudb;
3、删除数据库
drop database 数据库名;
#删除atguigudb数据库
drop database atguigudb;
4、使用自己的数据库
use 数据库名;

#使用atguigudb数据库
use atguigudb;
说明:如果没有使用use语句,后面针对数据库的操作也没有加“数据名”的限定,那么会报“ERROR 1046 (3D000): No database selected”(没有选择数据库)
使用完use语句之后,如果接下来的SQL都是针对一个数据库操作的,那就不用重复use了,如果要针对另一个数据库操作,那么要重新use。
2.2.2 数据表
1、查看某个库的所有表格
show tables from 数据库名;

show tables;  #如果是查看前面use的数据库中的所有表格,可以省略“from 数据库名”
2、创建新的表格
create table 【数据库名.】表名称( #如果新表是建在use的数据库中,可以省略表名前面的“数据库名.”
	字段名  数据类型,
	字段名 数据类型
);
说明:如果是最后一个字段,后面就用加逗号,因为逗号的作用是分割每个字段。
#创建学生表
create table student(
	id int,
    name varchar(20)  #要求名字最长不超过20个字符
);
3、查看定义好的表结构
desc 【数据库名.】表名称;
desc student; #如果要查看的表是在前面use的数据库中,可以省略表名前面的“数据库名.”
4、添加一条记录
insert into 【数据库名.】表名称 values(值列表);

#添加两条记录到student表中
#如果要添加记录的表是在前面use的数据库中,可以省略表名前面的“数据库名.”
insert into student values(1,'张三');
insert into student values(2,'李四');
5、查看一个表的数据
select * from 【数据库名.】表名称; #*表示查看所有列
select * from student;
6、删除表
drop table 【数据库名.】表名称;
#删除学生表
#如果要删除的表是在前面use的数据库中,可以省略表名前面的“数据库名.”
drop table student;
2.3 SQL的分类
数据查询语言(Data Query Language, DQL)- SELECT:用于从数据库表中查询数据。SELECT语句可以返回表中的特定列,所有列,或者通过计算得到的结果。它还可以结合WHERE、ORDER BY、GROUP BY等子句来对查询结果进行过滤、排序和分组。
- 数据定义语言(Data Definition Language, DDL)
- CREATE:用于创建新的数据库、表、索引、视图等对象。
- ALTER:用于修改已存在的数据库对象的结构,如修改表结构(增加、删除或修改列)。
- DROP:用于删除数据库、表、索引、视图等对象。
- TRUNCATE:用于删除表中的所有行,但不删除表本身,也不记录个别行删除的日志。
数据操纵语言(Data Manipulation Language, DML)- INSERT:用于向表中插入新的行。
- UPDATE:用于更新表中已存在的行。
- DELETE:用于从表中删除行。
- 数据控制语言(Data Control Language, DCL)
- GRANT:用于授予用户或角色对数据库对象的访问权限。
- REVOKE:用于撤销用户或角色之前被授予的权限。
- COMMIT:用于提交当前事务,使得自从事务开始以来所做的所有更改都成为永久性的。
- ROLLBACK:用于回滚当前事务,取消自从事务开始以来所做的所有更改。
- 事务控制语言(Transaction Control Language, TCL)
- 尽管DCL中的COMMIT和ROLLBACK也被用于事务控制,但TCL更广泛地指代那些控制事务的SQL语句。它还包括SAVEPOINT(用于在事务中设置保存点,以便在必要时回滚到该点)等语句
2.4 SQL语法规范
(1)mysql的sql语法不区分大小写
A:数据库的表中的数据是否区分大小写。这个的话要看表格的字段的数据类型、编码方式以及校对规则。
ci(大小写不敏感),cs(大小写敏感),_bin(二元,即比较是基于字符编码的值而与language无关,区分大小写)
B:sql中的关键字,比如:create,insert等,不区分大小写。但是大家习惯上把关键字都“大写”。
(2)命名时:尽量使用26个英文字母大小写,数字0-9,下划线,不要使用其他符号,不要使用纯数字来命名
(3)不要使用mysql的关键字等来作为表名、字段名、数据库名等,
(4)习惯上在SQL语句中表名、字段名、数据库名等使用`(飘号)引起来
(5)同一个mysql软件中,数据库不能同名,同一个库中,表不能重名,同一个表中,字段不能重名
show databases; -- 查看所有数据库
mysql> show tables;
+---------------------+
| Tables_in_atguigudb |
+---------------------+
| student             |
| temp                |
+---------------------+
2 rows in set (0.00 sec)

mysql> create table temp(id int);
ERROR 1050 (42S01): Table 'temp' already exists
mysql> create table tt(
    ->  id int,
    ->  id int
    -> );
ERROR 1060 (42S21): Duplicate(重复) column name 'id'
(6)数据库和表名、字段名等对象名中间不要包含空格
create database my atguigu;

ERROR 1064 (42000): You have an error in your SQL syntax; check the manual that corresponds to your MySQL server version for the right syntax to use near 'atguigu' at line 1
(7)给字段和表取别名时,as可以省略
- 表的别名不能包含空格
- 如果给字段取别名,也尽量不包含空格,包含字段别名中包含空格,请用双引号
select 字段名1 as 别名1, 字段名2 as 别名2 from 表名称 as 别名;
mysql> select * from student;
+------+------+
| id   | name |
+------+------+
|    1 | 张三 |
|    2 | 李四 |
+------+------+
2 rows in set (0.00 sec)

mysql> select id "学号",name "姓名" from student 学生表;
+------+------+
| 学号 | 姓名 |
+------+------+
|    1 | 张三 |
|    2 | 李四 |
+------+------+
2 rows in set (0.00 sec)

mysql> select id 学号,name 姓名 from student;
+------+------+
| 学号 | 姓名 |
+------+------+
|    1 | 张三 |
|    2 | 李四 |
+------+------+
2 rows in set (0.00 sec)

mysql> select id 学 号,name 姓 名 from student;
ERROR 1064 (42000): You have an error in your SQL syntax; check the manual that corresponds to your MySQL server version for the right syntax to use n
ear '号,name 姓 名 from student' at line 1
2.5 标点符号
mysql脚本中标点符号的要求如下:
-
本身成对的标点符号必须成对,例如:(),'',""。
-
所有标点符号必须英文状态下半角输入方式下输入。
几个特殊的标点符号:
-
小括号():在创建表、添加数据、函数使用、子查询、计算表达式等等会用()表示某个部分是一个整体结构。
-
单引号'':字符串和日期类型的数据值使用单引号''引起来,数值类型的不需要加标点符号。
-
双引号"":列的别名可以使用双引号"",给表名取别名
不要使用双引号。
create table tt(
    id int
    ;

ERROR 1064 (42000): You have an error in your SQL syntax; check the manual that corresponds to your MySQL server version for the right syntax to use near '' at line 2
create table temp(
	c char
);
insert into temp values('尚) ; #缺一半单引号

insert into temp values(‘尚’) ;  #标点符号是中文
mysql> select * from student;
+------+------+
| id   | name |
+------+------+
|    1 | 张三 |
|    2 | 李四 |
+------+------+
2 rows in set (0.00 sec)

mysql> select id "学号",name "姓名" from student;
+------+------+
| 学号 | 姓名 |
+------+------+
|    1 | 张三 |
|    2 | 李四 |
+------+------+
2 rows in set (0.00 sec)
2.6 SQL脚本中如何加注释
SQL脚本中如何加注释
-
单行注释:#注释内容(mysql特有的)
-
单行注释:--空格注释内容 其中--后面的空格必须有
-
多行注释:/* 注释内容 */
第3章 MySQL支持的数据类型
3.1 数值类型:包括整数和小数
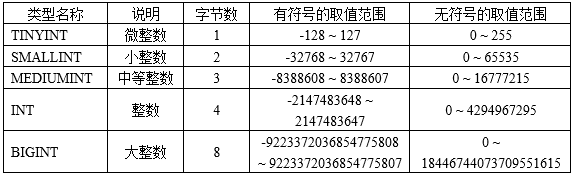
数值类型主要用来存储数字,不同的数值类型提供不同的取值范围,可以存储的值范围越大,所需要的存储空间也越大。MySQL支持所有标准SQL中的数值类型,其中包括严格数据类型(INTEGER、SMALLINT、DECIMAL、NUMERIC)和近似数值类型(FLOAT、REAL、DOUBLE PRECISION)。MySQL还扩展了TINYINT、MEDIUMINT和BIGINT等3种不同长度的整数类型,并增加了BIT类型,用来存储位数据。
对于MySQL中的数值类型,还要做如下说明:
-
关键字INT是INTEGER的同义词。
-
关键字DEC和FIXED是DECIMAL的同义词。
-
NUMERIC和DECIMAL类型被视为相同的数据类型。
-
DOUBLE视为DOUBLE PRECISION的同义词,并在REAL_AS_FLOAT SQL模式未启用的情况下,将REAL也视为DOUBLE PRECISION的同义词。
3.1.1.整数类型
说明:
对于整数类型,MySQL还支持在类型名称后面加小括号(M),而小括号中的M表示显示宽度,M的取值范围是(0, 255)。int(M)这个M在字段的属性中指定了unsigned(无符号)和zerofill(零填充)的情况下才有意义。表示当整数值不够M位时,用0填充。如果整数值超过M位但是没有超过当前数据类型的范围时,就按照实际位数存储。当M宽度超过当前数据类型可存储数值范围的最大宽度时,也是以实际存储范围为准。
MySQL8之前,int没有指定(M),默认显示(11)。最多能存储和显示11位整数。从MySQL 8.0.17开始,整数数据类型没有zerofill的情况下不推荐使用显示宽度属性,默认显示int。
3.1.2.bit类型
bit类型,如果没有指定(M),默认是1位。这个1位,那么表示只能存1位的二进制值。这里(M)是表示二进制的位数。M范围从1到64。
对于位类型字段,之前版本直接使用SELECT语句将不会看到结果,而在MySQL8版本中默认以“0X”开头的十六进制形式显示,可以通过BIN()函数显示为二进制格式。
3.1.3.小数类型
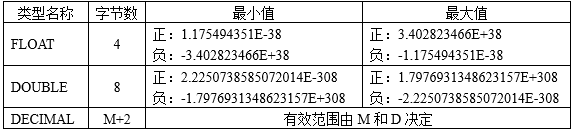
MySQL中使用浮点数和定点数来表示小数。浮点数有两种类型:单精度浮点数(FLOAT)和双精度浮点数(DOUBLE),定点数只有DECIMAL。浮点数和定点数都可以用(M,D)来表示。
- M是精度,表示该值总共显示M位,包括整数位和小数位,对于FLOAT和DOUBLE类型来说,M取值范围为0~255,而对于DECIMAL来说,M取值范围为0~65。
- D是标度,表示小数的位数,取值范围为0~30,同时必须<=M。
浮点型FLOAT(M,D) 和DOUBLE(M,D)是非标准用法,如果考虑到数据库迁移,则最好不要使用,而且从MySQL 8.0.17开始,FLOAT(M,D) 和DOUBLE(M,D)用法在官方文档中已经明确不推荐使用,将来可能被移除。另外,关于浮点型FLOAT和DOUBLE的UNSIGNED也不推荐使用了,将来也可能被移除。FLOAT和DOUBLE类型在不指定(M,D)时,默认会按照实际的精度来显示。DECIMAL类型在不指定(M,D)时,默认为(10,0),即只保留整数部分。例如,定义DECIMAL(5,2)的类型,表示该列取值范围是-999.99~999.99。如果用户插入数据的小数部分位数超过D位,MySQL会四舍五入处理,但是如果用户插入数据的整数部分位数超过“M-D”位,则会报“Out of range”的错误。
DECIMAL实际是以字符串形式存放的,在对精度要求比较高的时候(如货币、科学数据等)使用DECIMAL类型会比较好。浮点数相对于定点数的优点是在长度一定的情况下,浮点数能够表示更大的数据范围,它的缺点是会引起精度问题。
# 整数类型
# 整数类型支持指定 显示宽度 必须结合 unsigned zerofill 否则 没有意义
# 实际工作中都是直接使用 不会加 显示宽度

# 删除表格
drop table t_int;

create table t_int(
	i1 int,
	i2 int(5) unsigned zerofill  #没有unsigned zerofill,(2)没有意义
);

insert into t_int(i1,i2) values (1,1);
insert into t_int(i1,i2) values (100000,100000);


select * from t_int;


# bit位类型 如果没有指定宽度 则表示可以存储1位  指定的话 根据指定的位数 进行存储
create table t_bit(
	b1 bit,  #没有指定(M),默认是1位二进制
	b2 bit(4) #能够存储4位二进制0000~1111
);

insert into t_bit values(1,1);

select * from t_bit;

# 使用DOS命令窗口默认展示的为16进制的格式 可以使用bin函数转换为二进制格式

select bin(b1),bin(b2) from t_bit;


# double类型 宽度(M,D) M表示总宽度 D表示小数宽度
create table t_double(
	d1 double,
	d2 double(5,2)  #-999.99~999.99
);


insert into t_double values(2.5,2.5);
insert into t_double values(2.5,222.554); # 小数位超过 会截断 四舍五入


select * from t_double;


#创建表格
create table t_decimal(
	d1 decimal,  #没有指定(M,D)默认是(10,0) 存储小数 四舍五入
	d2 decimal(5,2)
);

insert into t_decimal(d1,d2) value(1.5,2.5);
insert into t_decimal(d1,d2) value(1.4,2.5);

select * from t_decimal;
3.2 字符串类型
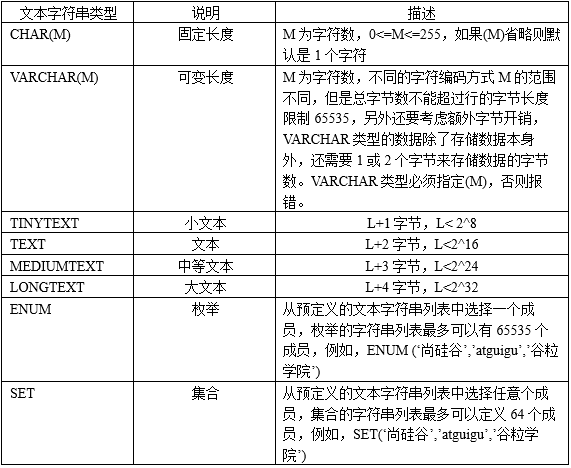
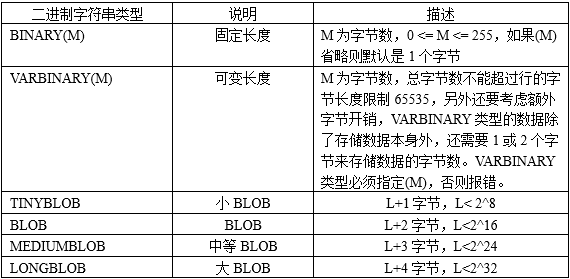
MySQL的字符串类型有CHAR、VARCHAR、BINARY、VARBINARY、BLOB、TEXT、ENUM、SET等。MySQL的字符串类型可以用来存储文本字符串数据,还可以存储二进制字符串。
文本字符串类型:
二进制字符串类型:
3.2.1.char和varchar
CHAR(M)为固定长度的字符串, M表示最多能存储的字符数,取值范围是0~255个字符,如果未指定(M)表示只能存储1个字符。例如CHAR(4)定义了一个固定长度的字符串列,其包含的字符个数最大为4,如果存储的值少于4个字符,右侧将用空格填充以达到指定的长度,当查询显示CHAR值时,尾部的空格将被删掉。
VARCHAR(M)为可变长度的字符串,M表示最多能存储的字符数,M的范围由最长的行的大小(通常是65535)和使用的字符集确定。例如utf8mb4字符编码单个字符所需最长字节值为4个字节,所以M的范围是[0, 16383]。而VARCHAR类型的字段实际占用的空间为字符串的实际长度加1或2个字节,这1或2个字节用于描述字符串值的实际字节数,即字符串值在[0,255]个字节范围内,那么额外增加1个字节,否则需要额外增加2个字节。
# char类型 如果不指定宽度 表示存储1个字符
create table t_char(
	c1 char,
    c2 char(3)
);

insert into t_char(c1,c2) values('a','abc');
insert into t_char(c1,c2) values("a","abc");

# 数据太长 无法添加
insert into t_char(c1,c2) values("a","abcd");


drop table t_varchar;
create table t_varchar(
	name varchar(3)   #错误
);

insert into t_varchar(name) values('a');
insert into t_varchar(name) values('ab');
insert into t_varchar(name) values('abc');
# 数据太长 无法添加
insert into t_varchar(name) values('abcd');
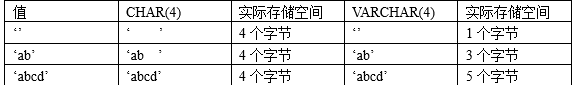
例如,身份证号、手机号码、QQ号、用户名username、密码password、银行卡号等固定长度的文本字符串适合使用CHAR类型,而评论、朋友圈、微博不定长度的文本字符串更适合使用VARCHAR类型。
另外,存储引擎对于选择CHAR和VARCHAR是有影响的。
- 对于MyISAM存储引擎,最好使用固定长度的数据列代替可变长度的数据列。这样可以使整个表静态化,从而使数据检索更快,用空间换时间。
- 对于InnoDB存储引擎,使用可变长度的数据列,因为InnoDB数据表的存储格式不分固定长度和可变长度,因此使用CHAR不一定比使用VARCHAR更好,但由于VARCHAR是按照实际的长度存储的,比较节省空间,所以对磁盘I/O和数据存储总量比较好。
3.2.2.Enum和Set类型
无论是数值类型、日期类型、普通的文本类型,可取值的范围都非常大,但是有时候我们指定在固定的几个值范围内选择一个或多个,那么就需要使用ENUM枚举类型和SET集合类型了。比如性别只有“男”或“女”;上下班交通方式可以有“地铁”、“公交”、“出租车”、“自行车”、“步行”等。枚举和集合类型字段声明的语法格式如下:
字段名ENUM(‘值1’,‘值2’,…‘值n’)
字段名 SET(‘值1’,‘值2’,…‘值n’)
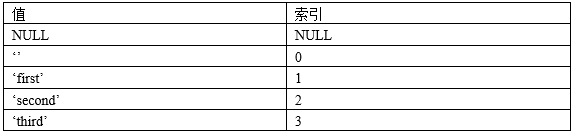
ENUM类型的字段在赋值时,只能在指定的枚举列表中取值,而且一次只能取一个。枚举列表最多可以有65535个成员。ENUM值在内部用整数表示,每个枚举值均有一个索引值, MySQL存储的就是这个索引编号。例如,定义ENUM类型的列(‘first’, ‘second’, ‘third’)。
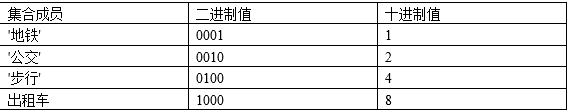
SET类型的字段在赋值时,可从定义的值列表中选择1个或多个值的组合。SET列最多可以有64个成员。SET值在内部也用整数表示,分别是1,2,4,8……,都是2的n次方值,因为这些整数值对应的二进制都是只有1位是1,其余是0。
演示枚举类型:
# 枚举类 集合类型
# 枚举属于多选1
# 集合属于多选多

create table t_enum_set(
	gender enum('男','女'),
    hobby set('睡觉','打游戏','唱歌','写代码')
);


insert into t_enum_set values('男','睡觉,打游戏'); #成功

insert into t_enum_set values('男,女','睡觉,打游戏'); #失败


insert into t_enum_set values('妖','睡觉,打游戏');#失败


insert into t_enum_set values('男','睡觉,打游戏,吃饭'); # 失败
3.2.3.BINARY和VARBINARY类型
BINARY和VARBINARY类似于CHAR和VARCHAR,只是它们存储的是二进制字符串。
BINARY (M)为固定长度的二进制字符串,M表示最多能存储的字节数,取值范围是0~255个字节,如果未指定(M)表示只能存储1个字节。例如BINARY (8),表示最多能存储8个字节,如果字段值不足(M)个字节,将在右边填充'\0'以补齐指定长度。
VARBINARY (M)为可变长度的二进制字符串,M表示最多能存储的字节数,总字节数不能超过行的字节长度限制65535,另外还要考虑额外字节开销,VARBINARY类型的数据除了存储数据本身外,还需要1或2个字节来存储数据的字节数。VARBINARY类型和VARCHAR类型一样必须指定(M),否则报错。
# 二进制字符串类型 比如可以存储字节流对应的数据

create table t_binary(
	b1 binary, #没有指定(M),默认是(1)
	b2 varbinary(10) #没有指定(M),报错,必须指定(M)
);

insert into t_binary
values('a','a');


select * from t_binary;
3.2.4.BLOB和TEXT类型
BLOB是一个二进制大对象,用来存储可变数量的二进制字符串,分为TINYBLOB、BLOB、MEDIUMBLOB、LONGBLOB四种类型。TINYTEXT、TEXT、MEDIUMTEXT和LONGTEXT四种文本类型,它们分别对应于以上四种BLOB类型,具有相同的最大长度和存储要求。
BLOB类型与TEXT类型的区别如下:
(1)BLOB类型存储的是二进制字符串,TEXT类型存储的是文本字符串。BLOB类型还可以存储图片和声音等二进制数据。
(2)BLOB类型没有字符集,并且排序和比较基于列值字节的数值,TEXT类型有一个字符集,并且根据字符集对值进行排序和比较。
# bolb 和  text类型
create table t_blob_text(
	b blob,  # 默认大小 64KB
	t text
);


select * from t_blob_text;
3.3 日期时间类型
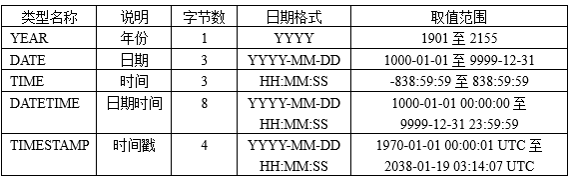
- 如果仅仅是表示年份信息,可以只使用YEAR类型,这样更节省空间,格式为“YYYY”,例如“2022”。YEAR允许的值范围是1901~2155。YEAR还有格式为“YY”2位数字的形式,值是00~69,表示2000~2069年,值是70~99,表示1970~1999年,从MySQL5.5.27开始,2位格式的YEAR已经不推荐使用。YEAR默认格式就是“YYYY”,没必要写成YEAR(4),从MySQL 8.0.19开始,不推荐使用指定显示宽度的YEAR(4)数据类型。这个0年,如果是以整数的0添加的话,那么是0000年,如果是以日期/字符串的'0'添加的话,是2000年。
- 如果要表示年月日,可以使用DATE类型,格式为“YYYY-MM-DD”,例如“2022-02-04”。
- 如果要表示时分秒,可以使用TIME类型,格式为“HH:MM:SS”,例如“10:08:08”。
- 如果要表示年月日时分秒的完整日期时间,可以使用DATATIME类型,格式为“YYYY-MM-DD HH:MM:SS”,例如“2022-02-04 10:08:08”。
- 如果需要经常插入或更新日期时间为系统日期时间,则通常使用TIMESTAMP类型,格式为“YYYY-MM-DD HH:MM:SS”,例如“2022-02-04 10:08:08”。TIMESTAMP与DATETIME的区别在于TIMESTAMP的取值范围小,只支持1970-01-01 00:00:01 UTC至2038-01-19 03:14:07 UTC范围的日期时间值,其中UTC是世界标准时间,并且TIMESTAMP类型的日期时间值在存储时会将当前时区的日期时间值转换为时间标准时间值,检索时再转换回当前时区的日期时间值,这会更友好。而DATETIME则只能反映出插入时当地的时区,其他时区的人查看数据必然会有误差的。另外,TIMESTAMP的属性受MySQL版本和服务器SQLMode的影响很大。因为timestamp底层存储的是该日期时间距离“1970-01-01 00:00:01 UTC”的秒值,是int类型的,所以存储范围有限。
# 只保留年份
create table year_temp(
	d year
);

insert into year_temp values(2021);
insert into year_temp values(85);
insert into year_temp values(22);
insert into year_temp values(69);
insert into year_temp values(0);
insert into year_temp values('0');

select * from year_temp;


create table date_time(
	d1 datetime,
	d2 timestamp
);

insert into date_time values('2021-9-2 14:45:52','2021-9-2 14:45:52');
3.4 其他类型
3.4.1.JSON类型
在MySQL5.7之前,如果需要在数据库中存储JSON数据只能使用VARCHAR或TEXT字符串类型。从5.7.8版本之后开始支持JSON数据类型。
3.4.2.空间类型
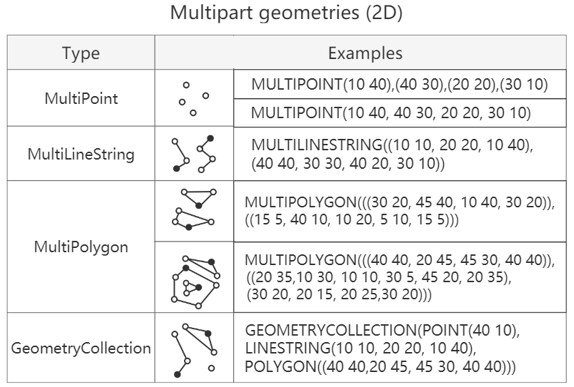
MySQL 空间类型扩展支持地理特征的生成、存储和分析。这里的地理特征表示世界上具有位置的任何东西,可以是一个实体,例如一座山;可以是空间,例如一座办公楼;也可以是一个可定义的位置,例如一个十字路口等等。现在的应用程序开发中空间数据的存储越来越多了,例如,钉钉的打卡位置是否在办公区域范围内,滴滴打车的位置、路线等。MySQL提供了非常丰富的空间函数以支持各种空间数据的查询和处理。
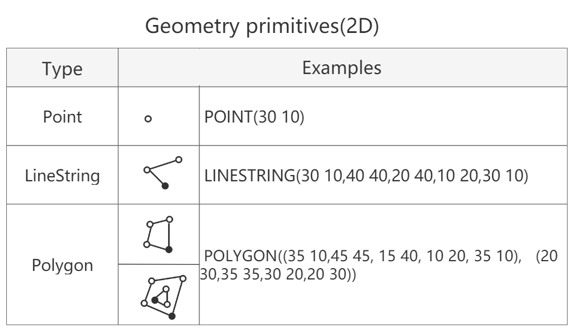
MySQL中使用Geometry(几何)来表示所有地理特征。Geometry指一个点或点的集合,代表世界上任何具有位置的事物。MySQL的空间数据类型(Spatial Data Type)对应于OpenGIS类,包括GEOMETRY、POINT、LINESTRING、POLYGON等单值类型以及MULTIPOINT、MULTILINESTRING、MULTIPOLYGON、GEOMETRYCOLLECTION存放不同几何值的集合类型。
第4章 运算符
4.1 算术运算符(掌握)
加:+
	在MySQL +就是求和,没有字符串拼接
减:-
乘:*
除:/   div(只保留整数部分)
	div:两个数相除只保留整数部分
	/:数学中的除
模:%   mod

mysql中没有 +=等运算符
# 算数运算符
# + - * / %

select  1 + 2 as '求和';
select  1 + 2 as "求和";
select  1 + 2  '求和';
select  1 + 2  求和;


select 1 + 2 as '求和', 1 -1 as '求差' , 2 * 2 , 2 / 1 , 10 % 3;
4.2 比较运算符(掌握)
大于:>
小于:<
大于等于:>=
小于等于:>=
等于:=   不能用于null判断
不等于:!=  或 <>  不能用于null判断
# 关系运算符

# 查询未成年的员工的姓名和年龄

select empname,empage from employee;

select empname,empage from employee where empage < 18;

select * from employee where empage < 18;

# 查询薪资大于15000的员工信息

select * from employee;

select * from employee where empsalary > 15000;


# 查询部门编号为1的员工信息

select * from employee where depid = 1;


# 查询部门编号不为1的员工信息

select * from employee where depid != 1;


# ------------------------------------------------


# = 和  != 不能用于null值的判断
# is null  用于判断为null值
# is not null  用于判断不为null值

# 查询员工备注信息为null的员工

select * from employee where empinfo = null;
select * from employee where empinfo is null;


# 查询员工备注信息不为null的员工

select * from employee where empinfo is not null;
4.3 区间或集合范围比较运算符(掌握)
区间范围:between x  and  y
	    not between x  and  y
集合范围:in (x,x,x)
	    not  in(x,x,x)
# between start  and  end
# 查询年龄在18 到 45 岁之间的人员信息

select * from employee where empage >= 18 and empage <= 45;
select * from employee where empage >= 18 && empage <= 45;


select * from employee where empage between 18 and 45;


# 查询年龄不在18 到 45 岁之间的人员信息

select * from employee where empage not between 18 and 45;


select * from employee where empage < 18 or empage > 45;
select * from employee where empage < 18 || empage > 45;
# 查询部门编号为1/2/3的人员信息

select * from employee where depid = 1 or depid = 2 or depid = 3;

# 使用in关键字实现 in关键字后边 应该加上一个数据集合

select * from employee where depid in(1,2,3);


# 查询部门编号不为1/2/3的人员信息

select * from employee where depid != 1 and depid != 2 and depid != 3;

select * from employee where depid not in(1,2,3);
4.4 模糊匹配比较运算符(掌握)
%:代表任意个字符
_:代表一个字符,如果两个下划线代表两个字符
# 模糊查询
# like
#  %  表示任意个数任意字符
#  _  表示一个任意字符

# 查询名字中包含'赵'的人员信息


select * from employee where empname like '%赵%';


# 查询名字以'赵'开头的人员信息

select * from employee where empname like '赵%';


# 查询名字以'赵'结尾的人员信息
select * from employee where empname like '%赵';


# 查询名字以'赵'开头的人员信息 并且名字只有两个字的人员信息

select * from employee where empname like '赵_';

# 查询名字以'赵'开头的人员信息 并且名字只有三个字的人员信息

select * from employee where empname like '赵__';
4.5 逻辑运算符(掌握)
逻辑与:&& 或 and
逻辑或:|| 或 or
逻辑非:! 或 not
逻辑异或: xor
#查询薪资高于15000,并且性别是男的员工

select * from employee where empsalary > 15000 and empsex = '男';
select * from employee where empsalary > 15000 && empsex = '男';


#查询薪资高于15000,或者depid为1的员工

select * from employee where empsalary > 15000 or depid = 1;
select * from employee where empsalary > 15000 || depid = 1;


#查询薪资不在[15000,20000]范围的

select * from employee where empsalary not between 15000 and 20000;


#查询薪资高于15000,或者depid为1的员工,两者只能满足其一

select * from employee where empsalary > 15000 xor depid = 1;
4.6 关于null值的问题(掌握)
4.7 位运算符(了解)
基本不用,知道一下
左移:<<
右移:>>
按位与:&
按位或:|
按位异或:^
按位取反:~
# 位运算符

select 1 << 1;
select 2 >> 1;
第5章 系统预定义函数
函数:代表一个独立的可复用的功能。
和Python中的方法有所不同,不同点在于:MySQL中的函数必须有返回值,参数可以有可以没有。
MySQL中函数分为:
(1)系统预定义函数:MySQL数据库管理软件给我提供好的函数,直接用就可以,任何数据库都可以用公共的函数。
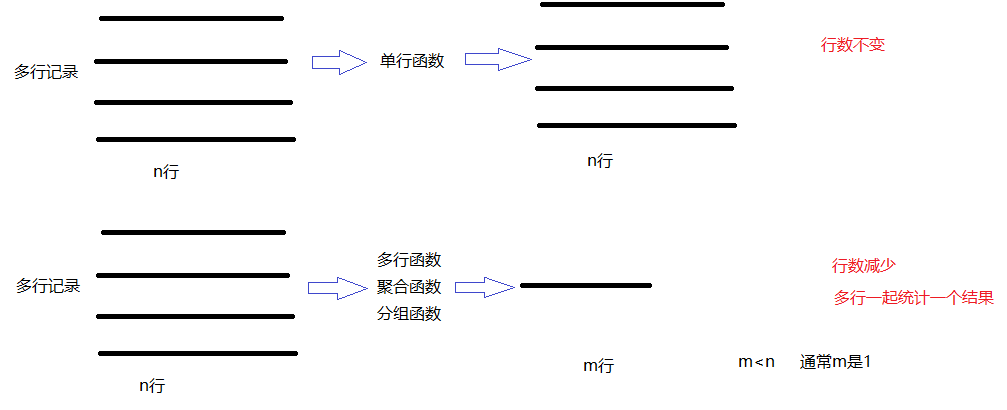
- 分组函数:或者又称为聚合函数,多行函数,表示会对表中的多行记录一起做一个“运算”,得到一个结果。
- 求平均值的avg,求最大值的max,求最小值的min,求总和sum,求个数的count等
- 单行函数:表示会对表中的每一行记录分别计算,有n行得到还是n行结果
- 数学函数、字符串函数、日期时间函数、条件判断函数、窗口函数等
(2)用户自定义函数:由开发人员自己定义的,通过CREATE FUNCTION语句定义,是属于某个数据库的对象。
5.1 分组函数
调用完函数后,结果的行数变少了,可能得到一行,可能得到少数几行。
分组函数有合并计算过程。
常用分组函数类型
- AVG(x) :求平均值
- SUM(x):求总和
- MAX(x) :求最大值
- MIN(x) :求最小值
- **COUNT(x) **:统计记录数
- ....
# avg(列名) 根据指定列求平均值
# 统计员工表员工平均年龄

select avg(empage) as 平均年龄  from employee;

# 使用四舍五入处理 保留2位小数
select round(avg(empage),2) as 平均年龄  from employee;


# 统计员工表员工平均薪资

select round(avg(empsalary),2) as '平均薪资' from employee;


# max(列名) 根据指定列求最大值

# 统计员工表最高薪资

select max(empsalary) as '最高薪资' from employee;


# 统计员工表最高薪资的员工的  姓名 和 薪资
# 这里查询最高薪资 但是 没有和后边的 姓名 和 薪资关联
# 所以是将最高薪资和员工表中的第一行数据 一起展示
select max(empsalary),empname,empsalary from employee;


# 使用子查询实现


select empname,empsalary from employee where empsalary = (select max(empsalary) from employee);


# 统计员工表最大年龄

select max(empage) as '最大年龄' from employee;

# min(列名) 根据指定列求最小值

# 统计员工表最小年龄

select min(empage) as '最小年龄' from employee;


# 统计员工表最低薪资

select min(empsalary) as '最低薪资' from employee;


# count(列名) 统计记录数

# 统计员工表人数

select count(1) as '总人数' from employee;

select count(*) as '总人数' from employee;


# 统计员工表有多少未成年人

select count(*) as '总人数' from employee where empage < 18;


# sum(列名) 根据指定列统计总和

# 统计员工表所有人的年龄总和

select sum(empage) from employee;


# 统计员工表所有人的薪资总和

select sum(empsalary) from employee;
5.2 单行函数(了解,用的时候查,太多了,演示一小部分)
调用完函数后,记录数不变,一行计算完之后还是一行。
5.2.1.数学函数
以下表格中也只是列出了一部分
| 函数 | 用法 |
|---|---|
| ABS(x) | 返回x的绝对值 |
| CEIL(x) | 返回大于x的最小整数值 |
| FLOOR(x) | 返回小于x的最大整数值 |
| MOD(x,y) | 返回x/y的模 |
| RAND() | 返回0~1的随机值 |
| ROUND(x,y) | 返回参数x的四舍五入的有y位的小数的值 |
| TRUNCATE(x,y) | 返回数字x截断为y位小数的结果 |
| FORMAT(x,y) | 强制保留小数点后y位,整数部分超过三位的时候以逗号分割,并且返回的结果是文本类型的 |
| SQRT(x) | 返回x的平方根 |
| POW(x,y) | 返回x的y次方 |
# 数学函数

select abs(-1234);


# 向上取整

select ceil(3.3);

# 向下取整

select floor(3.6);

# 四舍五入

select round(3.5);


# 随机数 0 ~ 1 之间的随机数 包括0不包括1  左闭右开

select rand();


# 截断小数

select truncate(3.3333333,2);

# 格式化数值的 格式化以后将变为文本类型

select format(659656656526.23565641,3);


# 平方根
select sqrt(9);

# 次幂
select pow(2,3);


#在“employee”表中查询员工无故旷工一天扣多少钱,
#分别用CEIL、FLOOR、ROUND、TRUNCATE函数。
#假设本月工作日总天数是22天,
#旷工一天扣的钱=salary/22。
SELECT empname,empsalary/22,CEIL(empsalary/22),
FLOOR(empsalary/22),ROUND(empsalary/22,2),
TRUNCATE(empsalary/22,2) FROM employee;


#查询公司平均薪资,并对平均薪资分别
#使用CEIL、FLOOR、ROUND、TRUNCATE函数
SELECT AVG(empsalary),CEIL(AVG(empsalary)),
FLOOR(AVG(empsalary)),ROUND(AVG(empsalary),2),
TRUNCATE(AVG(empsalary),2) FROM employee;
5.2.2.字符串函数
下面列出部分字符串函数:
| 函数 | 功能描述 |
|---|---|
| CONCAT(S1,S2,……Sn) | 连接S1,S2,……Sn为一个字符串 |
| CONCAT_WS(s,S1,S2,……Sn) | 同CONCAT(S1,S2,…)函数,但每个字符串之间要加上s |
| CHAR_LENGTH(s) | 返回字符串s的字符数 |
| LENGTH(s) | 返回字符串s的字节数,和字符集有关 |
| LOCATE(str1,str)或 POSITION(str1 in str)或 INSTR(str,str1) | 返回子字符串str1在str中的开始位置 |
| UPPER(s)或UCASE(s) | 将字符串s的所有字母转成大写字母 |
| LOWER(s)或LCASE(s) | 将字符串s的所有字母转成小写字母 |
| LEFT(s,n) | 返回字符串s最左边的n个字符 |
| RIGHT(s,n) | 返回字符串s最右边的n个字符 |
| LPAD(str,len,pad) | 用字符串pad对str最左边进行填充直到str的长度达到len |
| RPAD(str,len,pad) | 用字符串pad对str最右边进行填充直到str的长度达到len |
| LTRIM(s) | 去掉字符串s左侧的空格 |
| RTRIM(s) | 去掉字符串s右侧的空格 |
| TRIM(s) | 去掉字符串s开始与结尾的空格 |
| TRIM([BOTH] s1 FROM s) | 去掉字符串s开始与结尾的s1 |
| TRIM([LEADING] s1 FROM s) | 去掉字符串s开始处的s1 |
| TRIM([TRAILING]s1 FROM s) | 去掉字符串s结尾处的s1 |
| INSERT(str,index,len,instr) | 将字符串str从index位置开始len个字符的替换为字符串instr |
| REPLACE(str,a,b) | 用字符串b替换字符串str中所有出现的字符串a |
| REPEAT(str,n) | 返回str重复n次的结果 |
| REVERSE(s) | 将字符串反转 |
| STRCMP(s1,s2) | 比较字符串s1,s2 |
| SUBSTRING(s,index,len) | 返回从字符串s的index位置截取len个字符 |
| SUBSTRING_INDEX(str, 分隔符,count) | 如果count是正数,那么从左往右数,第n个分隔符的左边的全部内容。例如,substring_index("www.atguigu.com",".",1)是"www"。如果count是负数,那么从右边开始数,第n个分隔符右边的所有内容。例如,substring_index("www.atguigu.com",".",-1)是"com"。 |
# ------------------------------------------------
# 字符串函数
# concat() 拼接

select concat('a','b','c');

# 将员工的姓名和地址拼接在一起

select concat(empname,empaddress) from employee;


# concat_ws() 使用指定字符拼接指定的内容

select concat_ws('#','a','b','c');


select concat_ws('-----',empname,empaddress) from employee;


# char_length() 返回字符数

select char_length('abc');
select char_length('你好呀');


# length() 返回字节数
select length('abc');
select length('你好呀');


# upper() 转换为大写
select upper('abc');

# lower() 转换为小写

select lower("ABC");

# reverse() 翻转字符串

select reverse('abc');

# trim() 去除前后的空格
select trim('    a b c   ');

select length(trim('    a b c   '));

# replace()

select replace('abc abc','a','A');


#字符串函数
#mysql中不支持 + 拼接字符串,需要调用函数来拼接
#(1)在“employee”表中查询员工姓名和地址,
#并使用CONCAT函数,CONCAT_WS函数。

select concat(empname,empaddress),concat_ws('-',empname,empaddress) from employee;

#(2)在“employee”表中查询薪资高于15000的男员工姓名,
#并把姓名处理成“张xx”的样式。
#LEFT(s,n)函数表示取字符串s最左边的n个字符,
#而RPAD(s,len,p)函数表示在字符串s的右边填充p使得字符串长度达到len。

select left('abc',3);

select rpad('a',3,'x');


SELECT  RPAD(LEFT(empname,1),3,'*'),empsalary
FROM employee
WHERE empsalary>15000 AND empsex ='男';

#(3)在“employee”表中查询薪资高于10000的男员工姓名、
#姓名包含的字符数和占用的字节数。
select char_length(empname), length(empname) from employee;

select char_length(empname), length(empname)
from employee
where empsalary > 10000 and empsex = '男';


#(4)在“employee”表中查询薪资高于10000的男员工姓名和邮箱email,
#并把邮箱名“@”字符之前的字符串截取出来。

# 1表示从第一个字符开始截取
# 5表示截取长度为5
select substr('abc hello world',1,5);
select substring('abc hello world',1,5);

# 指定字符 或者 字符串 在 某个字符串中第一次出现的位置
select position('h' in 'habc abc hello');


SELECT empname,empemail,
SUBSTRING(empemail,1, POSITION('@' IN empemail) - 1)
FROM employee
WHERE empsalary > 10000 AND empsex ='男';

#mysql中 SUBSTRING截取字符串位置,下标从1开始,不是从0开始。
#mysql中 position等指定字符串中某个字符,子串的位置也不是从0开始,都是从1开始。

SELECT TRIM('    hello   world   '); #默认是去掉前后空白符
SELECT CONCAT('[',TRIM('    hello   world   '),']'); #默认是去掉前后空白符
SELECT TRIM(BOTH '&' FROM '&&&&hello   world&&&&'); #去掉前后的&符号
SELECT TRIM(LEADING '&' FROM '&&&&hello   world&&&&'); #去掉开头的&符号
SELECT TRIM(TRAILING '&' FROM '&&&&hello   world&&&&'); #去掉结尾的&符号
5.2.3.日期时间函数
| 函数 | 功能描述 |
|---|---|
| CURDATE()或CURRENT_DATE() | 返回当前系统日期 |
| CURTIME()或CURRENT_TIME() | 返回当前系统时间 |
| NOW()/SYSDATE()/CURRENT_TIMESTAMP()/ LOCALTIME()/LOCALTIMESTAMP() | 返回当前系统日期时间 |
| UTC_DATE()/UTC_TIME() | 返回当前UTC日期值/时间值 |
| UNIX_TIMESTAMP(date) | 返回一个UNIX时间戳 |
| YEAR(date)/MONTH(date)/DAY(date)/ HOUR(time)/MINUTE(time)/SECOND(time) | 返回具体的时间值 |
| EXTRACT(type FROM date) | 从日期中提取一部分值 |
| DAYOFMONTH(date)/DAYOFYEAR(date) | 返回一月/年中第几天 |
| WEEK(date)/WEEKOFYEAR(date) | 返回一年中的第几周 |
| DAYOFWEEK() | 返回周几,注意,周日是1,周一是2,…周六是7 |
| WEEKDAY(date) | 返回周几,注意,周一是0,周二是1,…周日是6 |
| DAYNAME(date) | 返回星期,MONDAY,TUESDAY,…SUNDAY |
| MONTHNAME(date) | 返回月份,January,… |
| DATEDIFF(date1,date2)/TIMEDIFF(time1,time2) | 返回date1-date2的日期间隔/返回time1-time2的时间间隔 |
| DATE_ADD(date,INTERVAL expr type)或ADDDATE/DATE_SUB/SUBDATE | 返回与给定日期相差INTERVAL时间段的日期 |
| ADDTIME(time,expr)/SUBTIME(time,expr) | 返回给定时间加上/减去expr的时间值 |
| DATE_FORMAT(datetime,fmt)/ TIME_FORMAT(time,fmt) | 按照字符串fmt格式化日期datetime值/时间time值 |
| STR_TO_DATE(str,fmt) | 按照字符串fmt对str进行解析,解析为一个日期 |
| GET_FORMAT(val_type,format_type) | 返回日期时间字符串的显示格式 |
函数中日期时间类型说明
| 参数类型 | 描述 | 参数类型 | 描述 |
|---|---|---|---|
| YEAR | 年 | YEAR_MONTH | 年月 |
| MONTH | 月 | DAY_HOUR | 日时 |
| DAY | 日 | DAY_MINUTE | 日时分 |
| HOUR | 时 | DAY_SECOND | 日时分秒 |
| MINUTE | 分 | HOUR_MINUTE | 时分 |
| SECOND | 秒 | HOUR_SECOND | 时分秒 |
| WEEK | 星期 | MINUTE_SECOND | 分秒 |
| QUARTER | 一刻 |
函数中format参数说明
| 格式符 | 说明 | 格式符 | 说明 |
|---|---|---|---|
| %Y | 4位数字表示年份 | %y | 两位数字表示年份 |
| %M | 月名表示月份(January,…) | %m | 两位数字表示月份(01,02,03,…) |
| %b | 缩写的月名(Jan.,Feb.,…) | %c | 数字表示月份(1,2,3…) |
| %D | 英文后缀表示月中的天数(1st,2nd,3rd,…) | %d | 两位数字表示表示月中的天数(01,02,…) |
| %e | 数字形式表示月中的天数(1,2,3,…) | %p | AM或PM |
| %H | 两位数字表示小数,24小时制(01,02,03,…) | %h和%I | 两位数字表示小时,12小时制(01,02,03,…) |
| %k | 数字形式的小时,24小时制(1,2,3,…) | %l | 数字表示小时,12小时制(1,2,3,…) |
| %i | 两位数字表示分钟(00,01,02,…) | %S和%s | 两位数字表示秒(00,01,02,…) |
| %T | 时间,24小时制(hh:mm:ss) | %r | 时间,12小时制(hh:mm:ss)后加AM或PM |
| %W | 一周中的星期名称(Sunday,…) | %a | 一周中的星期缩写(Sun.,Mon.,Tues.,…) |
| %w | 以数字表示周中的天数(0=Sunday,1=Monday,…) | %j | 以3位数字表示年中的天数(001,002,…) |
| %U | 以数字表示的的第几周(1,2,3,…) 其中Sunday为周中的第一天 | %u | 以数字表示年中的年份(1,2,3,…) 其中Monday为周中第一天 |
| %V | 一年中第几周(01~53),周日为每周的第一天,和%X同时使用 | %X | 4位数形式表示该周的年份,周日为每周第一天,和%V同时使用 |
| %v | 一年中第几周(01~53),周一为每周的第一天,和%x同时使用 | %x | 4位数形式表示该周的年份,周一为每周第一天,和%v同时使用 |
| %% | 表示% |
GET_FORMAT函数中val_type 和format_type参数说明
| 值类型 | 格式化类型 | 显示格式字符串 |
|---|---|---|
| DATE | EUR | %d.%m.%Y |
| DATE | INTERVAL | %Y%m%d |
| DATE | ISO | %Y-%m-%d |
| DATE | JIS | %Y-%m-%d |
| DATE | USA | %m.%d.%Y |
| TIME | EUR | %H.%i.%s |
| TIME | INTERVAL | %H%i%s |
| TIME | ISO | %H:%i:%s |
| TIME | JIS | %H:%i:%s |
| TIME | USA | %h:%i:%s %p |
| DATETIME | EUR | %Y-%m-%d %H.%i.%s |
| DATETIME | INTERVAL | %Y%m%d %H%i%s |
| DATETIME | ISO | %Y-%m-%d %H:%i:%s |
| DATETIME | JIS | %Y-%m-%d %H:%i:%s |
| DATETIME | USA | %Y-%m-%d %H.%i.%s |
#日期时间函数
/*
获取系统日期时间值
获取某个日期或时间中的具体的年、月等值
获取星期、月份值,可以是当天的星期、当月的月份
获取一年中的第几个星期,一年的第几天
计算两个日期时间的间隔
获取一个日期或时间间隔一定时间后的另个日期或时间
和字符串之间的转换
*/
#获取系统日期。CURDATE()和CURRENT_DATE()函数都可以获取当前系统日期。
SELECT CURDATE(),CURRENT_DATE();

#获取系统时间。CURTIME()和CURRENT_TIME()函数都可以获取当前系统时间。
SELECT CURTIME(),CURRENT_TIME();

#获取系统日期时间值。CURRENT_TIMESTAMP()、LOCALTIME()、SYSDATE()和NOW()
SELECT CURRENT_TIMESTAMP(),LOCALTIME(),SYSDATE(),NOW();

#获取当前UTC(世界标准时间)日期或时间值。
#本地时间是根据地球上不同时区所处的位置调整 UTC 得来的,
#例如,北京时间比UTC时间晚8个小时。
#UTC_DATE(),CURDATE(),UTC_TIME(), CURTIME()
SELECT UTC_DATE(),CURDATE(),UTC_TIME(), CURTIME();


#获取UNIX时间戳。
SELECT UNIX_TIMESTAMP(),UNIX_TIMESTAMP('2022-1-1');

select FROM_UNIXTIME(1742191454);


#获取具体的时间值,比如年、月、日、时、分、秒。
#分别是YEAR(date)、MONTH(date)、DAY(date)、HOUR(time)、MINUTE(time)、SECOND(time)。
SELECT YEAR(CURDATE()),MONTH(CURDATE()),DAY(CURDATE());
SELECT HOUR(CURTIME()),MINUTE(CURTIME()),SECOND(CURTIME());


#获取两个日期或时间之间的间隔。
#DATEDIFF(date1,date2)函数表示返回两个日期之间间隔的天数。
#TIMEDIFF(time1,time2)函数表示返回两个时间之间间隔的时分秒。

#查询现在离七夕还有多少天

select datediff('2025-07-07',now());


#查询现在距离下午放学还有多少时间

select timediff('17:30:00',CURRENT_TIME());


#在“employee”表中查询本月生日的员工姓名、生日。


select month(CURRENT_DATE());
SELECT empname,empbirthday
FROM employee
WHERE MONTH(CURDATE()) = MONTH(empbirthday);
5.2.4.加密函数
列出了部分的加密函数。
| 函数 | 用法 |
|---|---|
| password(str) | 返回字符串str的加密版本,41位长的字符串(mysql8不再支持) |
| md5(str) | 返回字符串str的md5值,也是一种加密方式 |
| SHA(str) | 返回字符串str的sha算法加密字符串,40位十六进制值的密码字符串 |
| SHA2(str,hash_length) | 返回字符串str的sha算法加密字符串,密码字符串的长度是hash_length/4。hash_length可以是224、256、384、512、0,其中0等同于256。 |
# 加密函数
# 加密函数
# d8ecbb27cd1f605b5d52f540bfc9a94f
select md5("abc");
select md5("abc");

# 1e7d78967c8981a27e3c4257190026bd
select md5("acb hello world");

# 050bdefd0c79dbcf50537738a3545eed4502c399
select SHA("abc hello world 666");

# de138b96f191251a4204c40bc42775dc29c8404a1aa8c9e1f36d8a4b28f83b10
#3ad7a706cab822e0dcdae7d44b42e09e234cde2d26ae2ee17385a76679b0cc0b0425d795f28d5d726ac32cce7746a0871134439be6205ae59f2e8ff57158a156
select SHA2("abc hello world 666",512);


# mysql 8 不再支持 password()

select password('abc');
5.2.5.系统信息函数
| 函数 | 用法 |
|---|---|
| database() | 返回当前数据库名 |
| version() | 返回当前数据库版本 |
| user() | 返回当前登录用户名 |
# database()
select database();

# user()
select user();

# version();
select version();
5.2.6.条件判断函数
| 函数 | 功能 |
|---|---|
| IF(value,t,f) | 如果value是真,返回t,否则返回f |
| IFNULL(value1,value2) | 如果value1不为空,返回value1,否则返回value2 |
| CASE WHEN 条件1 THEN result1 WHEN 条件2 THEN result2 … ELSE resultn END | 依次判断条件,哪个条件满足了,就返回对应的result,所有条件都不满足就返回ELSE的result。如果没有单独的ELSE子句,当所有WHEN后面的条件都不满足时则返回NULL值结果。 |
| CASE expr WHEN 常量值1 THEN 值1 WHEN 常量值2 THEN 值2 … ELSE 值n END | 判断表达式expr与哪个常量值匹配,找到匹配的就返回对应值,都不匹配就返回ELSE的值。如果没有单独的ELSE子句,当所有WHEN后面的常量值都不匹配时则返回NULL值结果。 |
# 条件函数
# IF(value,t,f) 如果第一个表达式结果为true 则执行 t  否则执行 FROM
# 查询员工表 根据年龄展示成年 以及 未成年

select empname,if(empage >= 18,'成年','未成年') from employee;


# IFNULL(value1,value2)
# 查询员工表 根据员工的备注信息判断 如果备注信息为空则展示 这个人很懒 什么都没写
# 如果不为空 则展示员工备注

select empname,ifnull(empinfo,'这个人很懒 什么都没写') from employee;


# CASE
#	WHEN 条件1  THEN result1
#	WHEN 条件2  THEN result2 …
#	ELSE resultn END

# 相当于Java中多重if

# 查询员工表的姓名 和 年龄 根据年龄划分年龄阶段

select empname,empage,
case
	when empage > 50 then '老年'
	when empage > 35 then '中年'
	when empage > 25 then '青年'
	when empage >= 18 then '成年'
	else '未成年' end as '年龄划分'
from employee;


# CASE expr
# WHEN 常量值1  THEN 值1
# WHEN 常量值2  THEN 值2 …
# ELSE 值n END


# 根据员工表 部门编号 打印对应的部门名称

select empname,depid,
case depid
	when 1 then '技术部'
	when 2 then '人社部'
	when 3 then '财务部'
	when 4 then '后勤部'
	when 5 then '文娱部'
	else '其他部门' end as '部门名称'
	from employee;
5.2.7.其他函数
从5.7.8版本之后开始支持JSON数据类型,并提供了操作JSON类型的数据的相关函数。
MySQL提供了非常丰富的空间函数以支持各种空间数据的查询和处理。
这两类函数基础阶段不讲,如果项目中有用到查询API使用。
5.3 窗口函数
窗口函数也叫OLAP函数(Online Anallytical Processing,联机分析处理),可以对数据进行实时分析处理。窗口函数是每条记录都会分析,有几条记录执行完还是几条,因此也属于单行函数。
| 函数 | 功能描述 |
|---|---|
| ROW_NUMBER() | 顺序排序,每行按照不同的分组逐行编号,例如:1,2,3,4 |
| RANK() | 并列排序,每行按照不同的分组进行编号,同一个分组中排序字段值出现重复值时,并列排序并跳过重复序号,例如:1,1,3 |
| DENSE_RANK() | 并列排序,每行按照不同的分组进行编号,同一个分组中排序字段值出现重复值时,并列排序不跳过重复序号,例如:1,1,2 |
窗口函数的语法格式如下
函数名([参数列表]) OVER ()
函数名([参数列表]) OVER (子句)
over关键字用来指定窗口函数的窗口范围。如果OVER后面是空(),则表示SELECT语句筛选的所有行是一个窗口。OVER后面的()中支持以下4种语法来设置窗口范围。
- WINDOW:给窗口指定一个别名;
- PARTITION BY子句:一个窗口范围还可以分为多个区域。按照哪些字段进行分区/分组,窗口函数在不同的分组上分别处理分析;
- ORDER BY子句:按照哪些字段进行排序,窗口函数将按照排序后结果进行分析处理;
# 查询每个人的姓名,薪资和公司的平均薪资

select empname,empsalary,(select avg(empsalary) from employee) from employee;


# 查询每个人的姓名,薪资和每个部门的平均薪资

select empname,empsalary,(select avg(empsalary) from employee group by depid) from employee;


# 使用窗口函数处理
# 格式  聚合函数()  over(具体分区子句)

select depid,empname,empsalary,avg(empsalary) over(partition by depid order by empsalary desc) from employee;


# 查询员工表 每个人的姓名 薪资 和每个部门的平均薪资
# 按照每个薪资升序排列
# 分别使用三种函数进行排列

select depid,empname,empsalary,
row_number() over(partition by depid order by empsalary) as 'row_number',
rank() over(partition by depid order by empsalary) as 'rank',
dense_rank() over(partition by depid order by empsalary) as 'dense_rank'
from employee;


select depid,empname,empsalary,
row_number() over w as 'row_number',
rank() over w as 'rank',
dense_rank() over w as 'dense_rank'
from employee window w as(partition by depid order by empsalary);
第6章 DML
6.1 添加语句
6.1.1.添加一条记录到某个表中
insert into 表名称 values(值列表); #值列表中的值的顺序、类型、个数必须与表结构一一对应
mysql> desc teacher;
+----------+------------------------+------+-----+---------+-------+
| Field    | Type                   | Null | Key | Default | Extra |
+----------+------------------------+------+-----+---------+-------+
| tid      | int(11)                | YES  |     | NULL    |       |
| tname    | varchar(5)             | YES  |     | NULL    |       |
| salary   | double                 | YES  |     | NULL    |       |
| weight   | double                 | YES  |     | NULL    |       |
| birthday | date                   | YES  |     | NULL    |       |
| gender   | enum('男','女')        | YES  |     | NULL    |       |
| blood    | enum('A','B','AB','O') | YES  |     | NULL    |       |
| phone    | char(11)               | YES  |     | NULL    |       |
+----------+------------------------+------+-----+---------+-------+
8 rows in set (0.00 sec)
insert into teacher values(1,'张三',15000,120.5,'1990-5-1','男','O','13789586859');
insert into teacher values(2,'李四',15000,'1990-5-1','男','O','13789586859'); #缺体重weight的值

ERROR 1136 (21S01): Column(列) count(数量) doesn't match(不匹配) value(值) count(数量) at row 1
6.1.2.添加一条记录到某个表中
insert into 表名称 (字段列表) values(值列表); #值列表中的值的顺序、类型、个数必须与(字段列表)一一对应
insert into teacher(tid,tname,salary,phone) values(3,'王五',16000,'15789546586');
6.1.3.添加多条记录到某个表中
insert into 表名称 values(值列表),(值列表),(值列表); #值列表中的值的顺序、类型、个数必须与表结构一一对应
insert into 表名称 (字段列表) values(值列表),(值列表),(值列表); #值列表中的值的顺序、类型、个数必须与(字段列表)一一对应
6.1.4.示例演示
# 添加数据

select * from department;

# 方式1
insert into department(depid,depname) values(8,'销售1部');

insert into department(depname,depid) values('销售2部',9);

# 方式2

insert into department values(10,'销售部');

# 方式3  针对于自动增长的主键列 可以不用写值 但是非主键列一定要写清楚给哪些列
# 传入哪些值

insert into department(depname) values('销售3部');


# 方式4 一次添加多条数据

insert into department values(12,'业务1部'),(13,'业务2部'),(14,'业务3部');

insert into department(depname) values('业务1部'),('业务2部'),('业务3部');
6.2 修改语句
# 修改数据
# update 表名  set 列1 = 值1,列2 = 值2…… where condition;
# 修改数据通常要加条件 如果不加条件 则修改整张表

# 修改赵四的薪资涨薪1000

select * from employee where empname = '赵四';

# 不加条件 所有人的薪资都涨1000
update employee set empsalary = empsalary + 1000;

# 根据指定条件修改
update employee set empsalary = empsalary + 1000 where empname = '赵四';

# 将赵四的薪资 涨薪为原来的1.5倍
update employee set empsalary = empsalary * 1.5 where empname = '赵四';
6.3 删除
# 删除操作 通常要加条件 否则将删除整张表
# delete from 表名 where condition;


select * from employee;

start transaction; # 开启事务 接下来的操作的数据会暂时放在缓存中

delete from employee;

rollback; # 回滚(撤销)
commit; # 提交


# 删除员工表中 年龄 大于 50人员信息

delete from employee where empage > 50 ;


# drop > truncate > delete
# drop 删除表结构 以及 表数据 									 					  不可回滚
# truncate 删除表数据 保留表结构  清空主键序号 不能加条件   不可回滚
# delete 删除表数据 保留表结构 保留主键序号 可以加条件      可以回滚

select * from department;

delete from department where depid > 7;

insert into department(depname) values('销售3部');

truncate table department;
第7 关联查询(联合查询)
7.1 什么是关联查询
关联查询:两个或更多个表一起查询。
前提条件:这些一起查询的表之间是有关系的(一对一、一对多),它们之间一定是有关联字段,这个关联字段可能建立了外键,也可能没有建立外键。
比如:员工表和部门表,这两个表依靠“部门编号”进行关联。
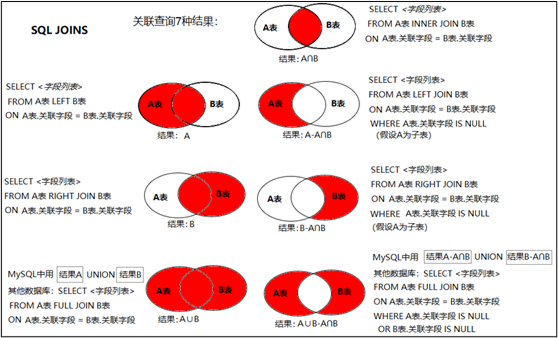
7.2 关联查询结果分为几种情况
7.3 关联查询的SQL有几种情况
1、内连接:inner join ... on
结果:A表 ∩ B表
2、左连接:A left join B on
(2)A表全部
(3)A表- A∩B
3、右连接:A right join B on
(4)B表全部
(5)B表-A∩B
4、全外连接:full outer join ... on,但是mysql不支持这个关键字,mysql使用union(合并)结果的方式代替
(6)A表∪B表: (2) A表结果 union (4)B表的结果
(7)A∪B - A∩B (3)A表- A∩B结果 union (5)B表-A∩B结果
select * from employee;

select * from department;

# 内连接 inner join  on condition
select * from employee inner join department on employee.depid = department.depid;

# 指定具体列来查询数据 如果多个表中有相同名称的列 必须使用 表名.列名的方式 书写
select empname,empid,department.depid,depname from employee inner join department on employee.depid = department.depid;

# 可以通过给表取别名的方式 简化SQL语句
select empname,empid,d.depid,depname
from employee as e inner join department as d on e.depid = d.depid;


# 左(外)连接  left join  on condition
# 以左表为主表 取交集
# 展示左表所有行 右表中未匹配的 以null填充

select * from employee left join department on employee.depid = department.depid;


# 右(外)连接 right join on condition
# 展示右表所有行 左表未匹配的以null填充
# 以右表为主表 取交集
select * from employee right join department on employee.depid = department.depid;


# 等值连接 取交集  结果 和 内连接想通

# 内连接写法
select * from employee inner join department on employee.depid = department.depid;

select * from employee,department where employee.depid = department.depid;
7.3.4.union 和 union all
# UNION 取并集 多条SQL语句查询列的数量必须一致  不保存重复记录

# 查询员工表所有女员工的信息
# 查询员工表 所有年龄小于30岁的人员信息

select * from employee where empsex = '女'
union
select * from employee where empage < 30;


select empname,empage from employee where empsex = '女'
union
select empname,empage from employee where empage < 30;


#多条SQL语句查询列的数量必须一致 否则报错   通常也会是相同的列
select empname from employee where empsex = '女'
union
select empage from employee where empage < 30;


# 查询员工表所有女员工的信息

# 查询员工表 所有年龄小于30岁的人员信息


# union all 取并集 多条SQL语句查询列的数量必须一致  会 保存重复记录

select * from employee where empsex = '女'
union all
select * from employee where empage < 30;
7.5 自连接
CREATE TABLE `course`  (
  `cid` int NULL DEFAULT NULL,
  `profession` varchar(255) CHARACTER SET utf8mb4 COLLATE utf8mb4_general_ci NULL DEFAULT NULL,
  `cname` varchar(255) CHARACTER SET utf8mb4 COLLATE utf8mb4_general_ci NULL DEFAULT NULL
) ENGINE = InnoDB CHARACTER SET = utf8mb4 COLLATE = utf8mb4_general_ci ROW_FORMAT = Dynamic;

-- ----------------------------
-- Records of course
-- ----------------------------
INSERT INTO `course` VALUES (1, 'Java', NULL);
INSERT INTO `course` VALUES (NULL, '1', 'JavaSE');
INSERT INTO `course` VALUES (NULL, '1', 'MySQL');
INSERT INTO `course` VALUES (NULL, '1', 'JDBC');
INSERT INTO `course` VALUES (NULL, '1', 'Spring');
INSERT INTO `course` VALUES (NULL, '1', 'MyBatis');
INSERT INTO `course` VALUES (NULL, '1', 'SpringBoot');
INSERT INTO `course` VALUES (2, 'H5', NULL);
INSERT INTO `course` VALUES (NULL, '2', 'VUE');
INSERT INTO `course` VALUES (NULL, '2', 'BootStrap');
INSERT INTO `course` VALUES (NULL, '2', 'Node.JS');
INSERT INTO `course` VALUES (NULL, '2', 'JQuery');
INSERT INTO `course` VALUES (NULL, '2', 'JavaScript');

# 自连接 将一张表 通过取别名的方式  当做两张表使用

select * from course;

select c1.profession,c2.cname from course as c1,course as c2 where c1.cid = c2.profession;
第8章 select子句
8.1 select各个子句顺序
(1)select
(2)from:从哪些表中筛选
(3)inner|left|right ...join on:关联多表查询时,去除笛卡尔积
(4)where:从表中筛选的条件
(5)group by:分组依据
(6)having:在分组统计结果中再次筛选(with rollup)
(7)order by:排序
(8)limit:分页
必须按照(1)-(8)的顺序编写子句。
8.2 演示
8.2.1 select 列表
SELECT语句是用于查看计算结果、或者查看从数据表中筛选出的数据的。
SELECT语句的基本语法:
SELECT 常量;
SELECT 表达式;
SELECT 函数;
SELECT *
SELECT 字段列表
SELECT DISTINCT 字段列表
8.2.2 from子句
8.2.3 on子句
8.2.4 where子句
8.2.5 group by子句
SELECT 常量;
SELECT 表达式;
SELECT 函数;
SELECT *
SELECT 字段列表
SELECT DISTICT 字段列表;


select 10;

select 2 + 3;

select now();

select * from employee;

select empname,empage from employee;
# 根据名字去除重复记录
select distinct empname,empage  from employee;


# group by 分组 通常结合聚合函数使用

# 统计员工表的平均薪资

select round(avg(empsalary),2) as '平均薪资' from employee;


# 统计员工表每个部门的平均薪资

select depid,round(avg(empsalary)) from employee group by depid;


# 分组以后通常要进行一些聚合性的操作 所以 不会查看某一条记录的信息了


# 查询部门编号,部门名称,部门的平均薪资

select employee.depid,depname,round(avg(empsalary))
from employee,department
where employee.depid = department.depid
group by employee.depid;


# 查询每一个部门的平均薪资,显示部门编号,部门的名称,该部门的平均薪资
# 要求,如果没有员工的部门,平均薪资不显示null,显示0

select department.depid,depname,ifnull(round(avg(empsalary)),0)
from employee right join department
on employee.depid = department.depid
group by employee.depid;


# 按照性别分组 统计男员工 以及 女员工的 平均薪资
#
select round(avg(empsalary),2),empsex  from employee group by empsex;


# 按照性别分组 统计男员工 以及 女员工的 平均年龄

select empsex,avg(empage) from employee group by empsex;


#是否可以按照多个字段分组统计
#按照不同的部门,分别统计男和女的员工人数


select empsex,count(1) from employee group by empsex;

select depid,empsex,count(1) from employee group by empsex,depid;
8.2.6 having子句
# having 作用和where相同 只不过在分组之后如果还需要过滤
# 只能使用having 不能使用where

# 查询年龄大于50的人员信息

select * from employee where empage > 50;

select * from employee having empage > 50;


# 查询每一个部门的员工平均薪资,显示部门编号,部门的名称,该部门的平均薪资
# 要求,如果没有员工的部门,平均薪资不显示null,显示0
# 最后只显示平均薪资高于8000的部门信息

select department.depid,depname,ifnull(avg(empsalary),0)
from department left join employee
on department.depid = employee.depid
group by department.depid
having avg(empsalary) > 20000;


# 查询每一个部门员工的人数

select depid,count(1) from employee group by depid;


# 查询每一个部门的男和女员工的人数

select depid,empsex,count(1) from employee group by depid,empsex;

# 查询员工表男女员工的总年龄

select empsex,sum(empage) from employee group by empsex;

# 查询每一个部门平均薪资超过7000的男和女员工的人数,显示部门编号,部门的名称,性别,人数,平均薪资
# 只显示人数大于1人

select employee.depid,depname,empsex,count(1) from employee,department
where employee.depid = department.depid
group by employee.depid,empsex
having count(1) > 1;
8.2.7 order by子句
# order by 排序 默认为升序  asc  可以省略


# 查询按照员工表信息 按照年龄升序排序

select * from employee;

select * from employee order by empage;

select * from employee order by empage asc;


# 降序 order by 列名 desc

# 查询按照员工表信息 按照年龄降序排序

select * from employee order by empage desc;


# 查询员工信息 按照薪资降序排序

select * from employee order by empsalary desc;
8.2.8 limit子句
# limit 在实际web系统中用于分页操作
# limit n 表示前n条数据


select * from employee limit 3;

select * from employee limit 5;

# limit n , m   表示从 n + 1 条开始展示 ,展示m条
# 假设每页需要展示4条数据

# 参数 (页码 - 1)  * 页容量 , 页容量

# 第一页
select * from employee limit 0,4;

# 第二页
select * from employee limit 4,4;


# 第三页
select * from employee limit 8,4;
第9章 子查询
9.1 SELECT的SELECT中嵌套子查询
# 查询每个人的姓名,年龄,薪资,公司的平均薪资


# 错误结果
select empname,empage,empsalary,avg(empsalary) from employee;

# 使用子查询实现

select empname,empage,empsalary,(select round(avg(empsalary),2) from employee)
from employee;


# 在“employee”表中查询每个人姓名,年龄,地址,薪资和公司平均薪资的差值。

select
	empname,
	empage,
	empaddress,
	empsalary,
	(select round(avg(empsalary),2)from employee) as '平均薪资',
	abs(empsalary - (select round(avg(empsalary),2)from employee)) as '薪资差值'
	from employee;


# 在“employee”表中查询每个人姓名,年龄,地址,薪资和公司平均薪资的差值。
# 并显示员工薪资和公司平均薪资相差15000元以上的记录。

select
	empname,
	empage,
	empaddress,
	empsalary,
	(select round(avg(empsalary),2)from employee) as '平均薪资',
	abs(empsalary - (select round(avg(empsalary),2)from employee)) as '薪资差值'
	from employee
	where abs(empsalary - (select round(avg(empsalary),2)from employee))  > 15000;
9.2 SELECT的WHERE或HAVING中嵌套子查询
当子查询结果作为外层另一个SQL的过滤条件,通常把子查询嵌入到WHERE或HAVING中。根据子查询结果的情况,分为如下三种情况。
- 当子查询的结果是单列单个值,那么可以直接使用比较运算符,如“<”、“<=”、“>”、“>=”、“=”、“!=”等与子查询结果进行比较。
- 当子查询的结果是单列多个值,那么可以使用比较运算符IN或NOT IN进行比较。
- 当子查询的结果是单列多个值,还可以使用比较运算符, 如“<”、“<=”、“>”、“>=”、“=”、“!=”等搭配ANY、SOME、ALL等关键字与查询结果进行比较。
# 查询年龄最大的人的姓名 和 年龄  地址

# 错误结果

select max(empage),empname,empage,empaddress from employee;


# 使用子查询
# 先通过子查询查询出来最大的年龄是多少岁

select empname,empaddress,empage from employee where empage = (select max(empage) from employee);


# 查询薪资最低的人员信息

select * from employee where empsalary = (select min(empsalary) from employee);

select * from employee where empsalary = (select min(empsalary) from employee) limit 1;
9.3 SELECT中的EXISTS型子查询
EXISTS型子查询也是存在外层SELECT的WHERE子句中,不过它和上面的WHERE型子查询的工作模式不相同,所以这里单独讨论它。
如果EXISTS关键字后面的参数是一个任意的子查询,系统将对子查询进行运算以判断它是否返回行,如果至少返回一行,那么EXISTS的结果为true,此时外层查询语句将进行查询;如果子查询没有返回任何行,那么EXISTS的结果为false,此时外层查询语句不进行查询。EXISTS和NOT EXISTS的结果只取决于是否返回行,而不取决于这些行的内容,所以这个子查询输入列表通常是无关紧要的。
如果EXISTS关键字后面的参数是一个关联子查询,即子查询的WHERE条件中包含与外层查询表的关联条件,那么此时将对外层查询表做循环,即在筛选外层查询表的每一条记录时,都看这条记录是否满足子查询的条件,如果满足就再用外层查询的其他WHERE条件对该记录进行筛选,否则就丢弃这行记录。
# exists 关键字 表示判断子查询是否有结果 如果有则执行外层的查询 如果没有结果 则不执行外层的查询

# 查询“employee”表中是否存在员工信息为NULL的员工,
# 如果存在,查询“department”表的部门编号、部门名称。

select * from department where exists(  select * from employee where empinfo is null);

# 查询“employee”表中是否存在员工年龄大于60的员工,
# 如果存在,查询“department”表的部门编号、部门名称。

select * from department where exists(  select * from employee where empage >  60);


# 查询“employee”表中是否存在员工信息为NULL的员工,
# 如果不存在,查询“department”表的部门编号、部门名称。

select * from department where not exists(  select * from employee where empinfo is  null);


# 查询“employee”表中是否存在员工年龄大于60的员工,
# 如果不存在,查询“department”表的部门编号、部门名称。

select * from department where not exists(  select * from employee where empage >  60);
9.4 SELECT的FROM中嵌套子查询
当子查询结果是多列的结果时,通常将子查询放到FROM后面,然后采用给子查询结果取别名的方式,把子查询结果当成一张“动态生成的临时表”使用。
# 查询每个部门的员工总薪资  返回部门名称和对应的总薪资

select depname,temp.avg_salary as '部门总薪资'  from department,
(select depid,sum(empsalary) as avg_salary from employee group by depid) as temp
where temp.depid = department.depid;
9.5 UPDATE中嵌套子查询
# 修改“employee”表中部门编号和
# “技术部”部门编号相同的员工薪资为原来薪资的1.5倍。

select * from employee where depid = 1;

update employee set empsalary = empsalary * 1.5 where depid = (select depid from department where depname = '技术部');


# 修改“employee”表中empinfo为NULL的员工信息,
# 将他们的depid值修改为“技术部”的部门编号。

select * from employee;

update employee set depid = (select depid from department where depname = '技术部')
where empinfo is null;
;


# 修改“employee”表中“赵四”的薪资值等于“大拿”的薪资值。
# 删除 修改 需要注意:外层sql和内层sql操作的是同一张表 必须使用临时表处理 否则报错
update employee set empsalary =
( select empsalary from  (select empsalary from employee where empname = '大拿') as temp)
where empname = '赵四';


select * from employee where empname = '赵四';


# 修改“employee”表“赵四”的薪资与他所在部门的平均薪资一样。

UPDATE employee
SET empsalary = (
	SELECT
		avg_salary
	FROM
		(
		SELECT
			avg( empsalary ) AS avg_salary
		FROM
			employee
		WHERE
		depid = ( SELECT depid FROM employee WHERE empname = '赵四' )) AS temp
	)  where empname = '赵四';


;
9.6 DELETE中嵌套子查询
# 从“employee”表中删除“后勤部”的员工记录。

select * from employee;

delete from employee where depid = (select depid from department where depname = '后勤部');


# 从“employee”表中删除和“赵四”同一个部门的员工记录。
#子查询 “刘德华”的部门编号

delete from employee where depid = (select depid from (select depid from employee where empname = '刘德华') as temp);
9.7 使用子查询复制表结构和数据(了解)
# 创建表 复制表结构
create table 表名 like 表名;
create table dep like department;
create table emp like employee;

# 复制数据
insert into 表名(select …… );
insert into dep  (select * from department);
insert into emp  (select * from employee);


# 创建表 同时 复制结构数据
create table 表名 as(select …… )
create table d as (select * from department);
第10章 约束(80%作为了解)
10.1 约束的作用
约束是为了保证数据的完整性,数据完整性(Data Integrity)是指数据的精确性(Accuracy)和可靠性(Reliability)。它是应防止数据库中存在不符合语义规定的数据和防止因错误信息的输入输出造成无效操作或错误信息而提出的。
数据的完整性要从以下四个方面考虑:
- 实体完整性(Entity Integrity):例如,同一个表中,不能存在两条完全相同无法区分的记录
- 域完整性(Domain Integrity):例如:年龄范围0-120,性别范围“男/女”
- 引用完整性(Referential Integrity):例如:员工所在部门,在部门表中要能找到这个部门
- 用户自定义完整性(User-defined Integrity):例如:用户名唯一、密码不能为空等,本部门经理的工资不得高于本部门职工的平均工资的5倍。
10.2 约束的类型
10.2.1.约束类型
- 键约束:主键约束、外键约束、唯一键约束
- Not NULL约束:非空约束
- Check约束:检查约束
- Default约束:默认值约束
自增是键约束字段的一个额外的属性。
10.2.2.表级约束和列级约束
其中键约束和检查约束是表级约束,即不仅要看约束字段当前单元格的数据,还要看其他单元格的数据。
非空约束和默认值约束都是列级约束,即约束字段只看当前单元格的数据即可,和其他单元格无关。
所有的表级约束都可以在“information_schema.table_constraints”表中查看。
SELECT * FROM information_schema.table_constraints WHERE table_schema = '数据库名' AND table_name = '表名称';
10.2.3.约束和索引
在MySQL中键约束会自动创建索引,提高查询效率。索引的详细讲解在高级部分。
MySQL高级会给大家讲解索引、存储引擎等,因为高级要给大家分析SQL性能。而基础阶段先不管效率,只要能查出来就行。
约束和索引不同:
约束是一个逻辑概念,它不会单独占用物理空间,
索引是一个物理概念,它是会占用物理空间。
例如:字典
字典里面有要求,不能有重复的字(字一样,读音也一样),这是约束。
字典里面有“目录”,它可以快速的查找某个字,目录需要占用单独的页。
10.3 非空约束
10.3.1.作用
限定某个字段/某列的值不允许为空
10.3.2.关键字:not null
10.3.3.特点
(1)只能某个列单独限定非空,不能组合非空
(2)一个表可以有很多列都分别限定了非空
10.3.4.如何指定非空约束
create table 表名称(
	字段名 数据类型 not null,
	字段名 数据类型 not null,
	字段名 数据类型
);
10.4 唯一键约束
10.4.1.唯一键约束的作用
单列唯一:用来限制某个字段/某列的值不能重复。
组合唯一:用来限定几个字段的值组合不能重复。
10.4.2.关键字:unique key
10.4.3.特点
(1)一个表可以有很多个唯一键约束,
(2)每一个唯一键约束字段都会自动创建索引。
(3)唯一键约束允许为空
(4)唯一键约束也可以是复合唯一
(5)删除唯一键约束的索引来删除唯一键约束
10.4.4.如何指定唯一键约束
#在建表时,可以指定唯一键约束
create table 表名称(
	字段名 数据类型 unique key,
	字段名 数据类型 unique key,
	字段名 数据类型
);

create table 表名称(
	字段名 数据类型,
	字段名 数据类型,
	字段名 数据类型,
	unique key(字段名),
	unique key(字段名)
);
SELECT * FROM information_schema.table_constraints WHERE table_name = 'employee';

# 非空约束
# 唯一约束

create table student(
	stuid int not null comment '学生编号',
	stuname varchar(20) not null comment '学生姓名',
	stu_id_card varchar(20) not null unique key comment '学生身份证号',
	unique key(stuid,stuname) # 复合唯一
);
10.5 主键约束(重要)
10.5.1.主键约束的作用
用来唯一的确定一条记录
10.5.2.关键字:primary key
10.5.3.特点
(1)唯一并且非空
(2)一个表最多只能有一个主键约束
(3)如果主键是由多列组成,可以使用复合主键
(4)主键列会自动创建索引(能够根据主键查询的,就根据主键查询,效率更高)
主键列的唯一并且非空是约束的概念,但是mysql会给每个表的主键列创建索引,会开辟单独的物理空间来存储每一个主键的目录表(Btree结构)。这样设计的意义,可以根据主键快速查询到某一行的记录。
(5)如果删除主键约束了,主键约束对应的索引就自动删除了,但是非空约束不会自动删除。
10.5.4.唯一键约束和主键约束区别
4、唯一键约束和主键约束的区别
(1)唯一键约束一个表可以有好几个,
但是主键约束只有一个
(2)唯一键约束本身不带非空限制,如果需要非空,需要单独定义。
主键约束不用再定义NOT NULL,自身就带非空限制。
10.5.5.如何指定主键约束
create table 表名称(
	字段名  数据类型  primary key,
    字段名  数据类型,
    字段名  数据类型
);
create table 表名称(
	字段名  数据类型,
    字段名  数据类型,
    字段名  数据类型,
    primary key(字段名)
);
create table person(
	pid int primary key auto_increment comment '人员编号',
	pname varchar(20) not null comment '人员姓名',
	psex enum('男','女') default '男' comment '人员性别'
);
10.5.6.复合主键
create table 表名称(
	字段名  数据类型,
    字段名  数据类型,
    字段名  数据类型,
    primary key(字段名1,字段名2)  #表示字段1和字段2的组合是唯一的,也可以有更多个字段
);
10.6 默认值约束
10.6.1.作用
给某个字段/某列指定默认值,当添加时或修改时,可以使用默认值。
10.6.2.关键字:default
10.6.3.如何给字段加默认值
create table 表名称(
	字段名  数据类型  primary key,
    字段名  数据类型  【unique key】 【not null】,
    字段名  数据类型  【not null】 【default 默认值】
);
10.7 自增属性
10.7.1.作用
作用:给某个字段自动赋值,这个值是一直往上增加,如果没有特意干扰的,每次自增1.
10.7.2.关键字:auto_increment
10.7.3.特点和要求
(1)一个表只能有一个自增字段,因为一个表只有一个AUTO_INCREMENT属性记录自增字段值
(2)并且自增字段只能是key字段,即定义了主键、唯一键等键约束的字段。
一般都是给主键和唯一键加自增。
(3)自增字段应该是数值类型,一般都是整数类型。
(4)如果自增列指定了 0 和 null,会在当前最大值的基础上自增,
如果自增列手动指定了具体值,直接赋值为具体值。
(5)如果手动修改AUTO_INCREMENT属性值, 必须 > 当前自增字段的最大值
10.8 检查约束
10.8.1.作用
检查(CHECK) 约束用于限制字段中的值的范围。如果对单个字段定义 CHECK 约束,那么该字段只允许特定范围的值。如果对一个表定义 CHECK 约束,那么此约束会基于行中其他字段的值在特定的字段中对值进行限制。
在MySQL 8.0.16版本之前, CREATE TABLE语句支持给单个字段定义CHECK约束的语法,但是不起作用。
10.8.2.关键字:check
例如MySQL8.0之前,就算给表定义了检查约束,也不起作用。在MySQL8.0.16版本之后,CREATE TABLE语句既支持给单个字段定义列级CHECK约束的语法,还支持定义表级CHECK约束的语法。
10.8.3.如何定义检查约束
#在建表时,可以指定检查约束
create table 表名称(
	字段名1 数据类型 check(条件) 【enforced】,  #在字段后面直接加检查约束
	字段名2 数据类型,
	字段名3 数据类型,
	check (条件)  【enforced】#可以限定两个字段之间的取值条件
);
create table p(
	page int check(page >= 18)
);
10.9 外键约束(了解)
外键约束会影响性能,效率,所以很多人不愿意加外键约束。
学生问题:
(1)如果两个表之间有关系(一对一、一对多),比如:员工表和部门表(一对多),它们之间是否一定要建外键约束?
答:不是的
(2)建和不建外键约束有什么区别?
答:
建外键约束,你的操作(创建表、删除表、添加、修改、删除)会受到限制,从语法层面受到限制。例如:在员工表中不可能添加一个员工信息,它的部门的值在部门表中找不到。
不建外键约束,你的操作(创建表、删除表、添加、修改、删除)不受限制,要保证数据的引用完整性,只能依靠程序员的自觉,或者是在Python程序中进行限定。例如:在员工表中,可以添加一个员工的信息,它的部门指定为一个完全不存在的部门。
(3)那么建和不建外键约束和查询有没有关系?
答:没有
10.9.1.作用
限定某个表的某个字段的引用完整性,
比如:员工表的员工所在部门的选择,必须在部门表能找到对应的部分。
10.9.2.关键字:foreign key
10.9.3.主表和从表/父表和子表
主表(父表):被引用的表,被参考的表
从表(子表):引用别人的表,参考别人的表
例如:员工表的员工所在部门这个字段的值要参考部门表,
部门表是主表,员工表是从表。
例如:学生表、课程表、选课表
选课表的学生和课程要分别参考学生表和课程表,
学生表和课程表是主表,选课表是从表。
10.9.4.特点
(1)在“从表”中指定外键约束,并且一个表可以建立多个外键约束
(2)创建(create)表时就指定外键约束的话,先创建主表,再创建从表
(3)删表时,先删从表(或先删除外键约束),再删除主表。或者先解除关系,再各自删除。
(4)从表的外键列,必须引用/参考主表的键列(主键或唯一键)
为什么?因为被依赖/被参考的值必须是唯一的
(5)从表的外键列的数据类型,要与主表被参考/被引用的列的数据类型一致,并且逻辑意义一致。
例如:都是表示部门编号,都是int类型。
(6)外键列也会自动建立索引(根据外键查询效率很高,很多)
(7)外键约束的删除,所以不会自动删除索引,如果要删除对应的索引,必须手动删除
10.9.5.如何指定外键约束
create table 主表名称(
	字段1  数据类型  primary key,
    字段2  数据类型
);

create table 从表名称(
	字段1  数据类型  primary key,
    字段2  数据类型,
    foreign key (从表的某个字段) references 主表名(被参考字段)
);
#(从表的某个字段)的数据类型必须与主表名(被参考字段)的数据类型一致,逻辑意义也一样
#(从表的某个字段)的字段名可以与主表名(被参考字段)的字段名一样,也可以不一样
#演示外键约束
#建表时,指定外键约束
drop table if exists dept;
create table dept(
	did int primary key auto_increment,
	dname varchar(50) unique key not null
);

drop table if exists emp;
create table emp(
	id int primary key auto_increment,
	name varchar(20) not null,
	departmentid int,  #子表中外键约束的字段名和父表的被引用字段名不要求一致,但是数据类型和逻辑意义要一样
	#外键约束只能在字段列表下面单独定义,不能在字段后面直接定义
	foreign key (departmentid) references dept(did)
);
10.9.6.演示问题
(1)失败:不是键列
create table dept(
	did int ,		#部门编号
    dname varchar(50)			#部门名称
);

create table emp(
	eid int primary key,  #员工编号
    ename varchar(5),     #员工姓名
    deptid int,				#员工所在的部门
    foreign key (deptid) references dept(did)
);ERROR 1215 (HY000): Cannot add foreign key constraint  原因是dept的did不是键列
(2)失败:数据类型不一致
create table dept(
	did int primary key,		#部门编号
    dname varchar(50)			#部门名称
);

create table emp(
	eid int primary key,  #员工编号
    ename varchar(5),     #员工姓名
    deptid char,				#员工所在的部门
    foreign key (deptid) references dept(did)
);ERROR 1215 (HY000): Cannot add foreign key constraint  原因是从表的deptid字段和主表的did字段的数据类型不一致,并且要它俩的逻辑意义一致
(3)成功,两个表字段名一样
create table dept(
	did int primary key,		#部门编号
    dname varchar(50)			#部门名称
);

create table emp(
	eid int primary key,  #员工编号
    ename varchar(5),     #员工姓名
    did int,				#员工所在的部门
    foreign key (did) references dept(did)
    #emp表的deptid和和dept表的did的数据类型一致,意义都是表示部门的编号
    #是否重名没问题,因为两个did在不同的表中
);
10.9.7.设置外键约束等级
-
Cascade方式:在父表上update/delete记录时,同步update/delete掉子表的匹配记录
-
Set null方式:在父表上update/delete记录时,将子表上匹配记录的列设为null,但是要注意子表的外键列不能为not null
-
No action方式:如果子表中有匹配的记录,则不允许对父表对应候选键进行update/delete操作
-
Restrict方式:同no action, 都是立即检查外键约束
-
Set default方式(在可视化工具SQLyog中可能显示空白):父表有变更时,子表将外键列设置成一个默认的值,但Innodb不能识别
如果没有指定等级,就相当于Restrict方式。
第11章 修改表结构和约束(了解)
11.1 修改表结构
drop table if exists teacher;
create table teacher(
	tid int,
    tname varchar(5),
    salary double,
    weight double(5,2),
    birthday date,
    gender enum('男','女'),
    blood enum('A','B','AB','O'),
	tel char(11)
);
11.1.1.修改表名称:重命名表
alter table 旧表名 rename 【to】 新表名;
rename table 旧表名称 to 新表名称;
例如:
alter table teacher rename to t_tea;
rename table t_tea to teacher;
11.1.2.修改表结构:删除字段
alter table 表名称 drop 【column】 字段名称;
alter table teacher drop column weight;
11.1.3.修改表结构:增加字段
alter table 表名称 add 【column】 字段名称 数据类型;
alter table 表名称 add 【column】 字段名称 数据类型 first;
alter table 表名称 add 【column】 字段名称 数据类型 after 另一个字段;
alter table teacher add weight double(5,2);
alter table teacher drop column weight;

alter table teacher add weight double(5,2) first;
alter table teacher drop column weight;

alter table teacher add weight double(5,2) after salary;
alter table teacher drop column weight;
11.1.4.修改表结构:修改字段的名称
alter table 表名称 change 【column】 旧字段名称 新的字段名称 新的数据类型;
mysql> desc teacher;
+----------+------------------------+------+-----+---------+-------+
| Field    | Type                   | Null | Key | Default | Extra |
+----------+------------------------+------+-----+---------+-------+
| tid      | int(11)                | YES  |     | NULL    |       |
| tname    | varchar(5)             | YES  |     | NULL    |       |
| salary   | double                 | YES  |     | NULL    |       |
| weight   | double                 | YES  |     | NULL    |       |
| birthday | date                   | YES  |     | NULL    |       |
| gender   | enum('男','女')        | YES  |     | NULL    |       |
| blood    | enum('A','B','AB','O') | YES  |     | NULL    |       |
| tel      | char(11)               | YES  |     | NULL    |       |
+----------+------------------------+------+-----+---------+-------+
8 rows in set (0.00 sec)

mysql> alter table teacher change tel phone char(11);
Query OK, 0 rows affected (0.01 sec)
Records: 0  Duplicates: 0  Warnings: 0

mysql> desc teacher;
+----------+------------------------+------+-----+---------+-------+
| Field    | Type                   | Null | Key | Default | Extra |
+----------+------------------------+------+-----+---------+-------+
| tid      | int(11)                | YES  |     | NULL    |       |
| tname    | varchar(5)             | YES  |     | NULL    |       |
| salary   | double                 | YES  |     | NULL    |       |
| weight   | double                 | YES  |     | NULL    |       |
| birthday | date                   | YES  |     | NULL    |       |
| gender   | enum('男','女')        | YES  |     | NULL    |       |
| blood    | enum('A','B','AB','O') | YES  |     | NULL    |       |
| phone    | char(11)               | YES  |     | NULL    |       |
+----------+------------------------+------+-----+---------+-------+
8 rows in set (0.00 sec)
11.1.5.修改表结构:修改字段的数据类型等
alter table 表名称 modify 【column】 字段名称 新的数据类型;
alter table 表名称 modify 【column】 字段名称 数据类型 first;
alter table 表名称 modify 【column】 字段名称 数据类型 after 另一个字段;
drop table if exists teacher;
create table teacher(
	tid int,
    tname varchar(5),
    salary double,
    weight double(5,2),
    birthday date,
    gender enum('男','女'),
    blood enum('A','B','AB','O'),
	tel char(11)
);

# 修改表名
alter table teacher rename to t_teacher;

rename table t_teacher to teacher;


# 删除字段
alter table teacher drop column weight;

# 添加字段
alter table 表名称 add 【column】 字段名称 数据类型;
alter table 表名称 add 【column】 字段名称 数据类型 first;
alter table 表名称 add 【column】 字段名称 数据类型 after 另一个字段;

alter table teacher add weight double;

alter table teacher add weight double first;


alter table teacher add  weight double after tel;


#  修改字段名称
# alter table 表名称 change 【column】 旧字段名称 新的字段名称 新的数据类型;

alter table teacher change tel phone varchar(100);


# 修改字段类型
alter table 表名称 modify 【column】 字段名称 新的数据类型;
alter table 表名称 modify 【column】 字段名称 数据类型 first;
alter table 表名称 modify 【column】 字段名称 数据类型 after 另一个字段;


alter table teacher modify phone char(20);


# 增加或者删除主键
alter table 表名称 add primary key(字段名);
alter table 表名称 add primary key(字段列表);#复合主键
alter table 表名称 drop primary key;

alter table teacher add primary key(tid);

alter table teacher drop primary key;

# 添加唯一约束

alter table 表名称 add unique 【key】(字段名);
alter table 表名称 add unique 【key】(字段列表);#复合唯一键

alter table teacher add unique key(phone);


#删除唯一键约束需要手动删除对应的索引
alter table 表名称 drop index 索引名;

alter table teacher drop index phone;

# 修改非空、默认值约束、自增
alter table 表名称 modify  字段名称 新的数据类型;

alter table teacher modify tid int primary key auto_increment comment '老师编号';


# 增加检查约束

alter table 表名称 add check(条件);

# 删除检查约束

alter table 表名称 drop check 检查约束名;


alter table teacher add check(salary < 20000);


alter table teacher drop check teacher_chk_1;


# 添加列
alter table teacher add cityid int comment '城市编号';
11.2 修改约束
drop table if exists teacher;
create table teacher(
	tid int,
    tname varchar(5),
    cardid char(18),
    gender enum ('男','女'),
	age int
);
11.2.1.增加或删除主键
alter table 表名称 add primary key(字段名);
alter table 表名称 add primary key(字段列表);#复合主键
alter table 表名称 drop primary key;
desc teacher;

alter table teacher add primary key(tid);

desc teacher;

alter table teacher drop primary key;

desc teacher;
11.2.2.增加或删除唯一键
#如何在建表后添加唯一键约束
alter table 表名称 add unique 【key】(字段名);
alter table 表名称 add unique 【key】(字段列表);#复合唯一键
alter table 表名称 drop index 索引名;
#删除唯一键约束需要手动删除对应的索引
show index from 表名称;
SELECT * FROM information_schema.table_constraints WHERE table_name = '表名称';
alter table teacher add unique key (cardid);
alter table teacher drop index cardid;
11.2.3.修改表结构:修改非空、默认值约束、自增
alter table 表名称 modify 【column】 字段名称 新的数据类型 【not null】 【default 默认值】 【auto_increment】;
alter table teacher modify column tid int auto_increment;#键列才能加自增
alter table teacher modify column tname varchar(5) not null;
alter table teacher modify column gender enum ('男','女') not null default '男';
11.2.4.增加或删除检查约束
#如何在建表后添加检查约束,使用add check
alter table 表名称 add check(条件);
alter table 表名称 drop check 检查约束名;
SELECT * FROM information_schema.table_constraints WHERE table_name = '表名称';
alter table teacher add check(age>=18);

SELECT * FROM information_schema.table_constraints WHERE table_name = 'teacher';

alter table teacher drop check teacher_chk_1;
5、增加或删除外键约束
alter table 从表名称 add foreign key (从表的字段) references 主表(被引用字段) 【on update xx】【on delete xx】;
删除外键约束,不会自动删除外键约束列的索引,需要单独删除。
# 增加或者删除主键
alter table 表名称 add primary key(字段名);
alter table 表名称 add primary key(字段列表);#复合主键
alter table 表名称 drop primary key;

alter table teacher add primary key(tid);

alter table teacher drop primary key;

# 添加唯一约束

alter table 表名称 add unique 【key】(字段名);
alter table 表名称 add unique 【key】(字段列表);#复合唯一键

alter table teacher add unique key(phone);


#删除唯一键约束需要手动删除对应的索引
alter table 表名称 drop index 索引名;

alter table teacher drop index phone;

# 修改非空、默认值约束、自增
alter table 表名称 modify  字段名称 新的数据类型;

alter table teacher modify tid int primary key auto_increment comment '老师编号';


# 增加检查约束

alter table 表名称 add check(条件);

# 删除检查约束

alter table 表名称 drop check 检查约束名;


alter table teacher add check(salary < 20000);


alter table teacher drop check teacher_chk_1;


# 添加列
alter table teacher add cityid int comment '城市编号';


# 增加或者删除外键

alter table 从表名称 add foreign key (从表的字段) references 主表(被引用字段) 【on update xx】【on delete xx】;

alter table teacher add foreign key(cityid) references city(cid);


# (1)第一步先查看约束名和删除外键约束
show create table 从表名称; #可以看到外键约束名
SELECT * FROM information_schema.table_constraints WHERE table_name = '表名称';#查看某个表的约束名

alter table 从表名 drop foreign key 外键约束名;

# (2)第二步查看索引名和删除索引
show index from 表名称; #查看某个表的索引名

alter table 从表名 drop index 索引名;


SELECT * FROM information_schema.table_constraints WHERE table_name = 'teacher';


alter table teacher drop foreign key teacher_ibfk_1;

alter table teacher drop index cityid;
第12章 事务(重点)
12.1 事务的特点
1、事务处理(事务操作):保证所有事务都作为一个工作单元来执行,即使出现了故障,都不能改变这种执行方式。当在一个事务中执行多个操作时,要么所有的事务都被提交(commit),那么这些修改就永久地保存下来;要么数据库管理系统将放弃所作的所有修改,整个事务回滚(rollback)到最初状态。
2、事务的ACID属性:
(1)原子性(Automicity) 原子性是指事务是一个不可分割的工作单位,事务中的操作要么都发生,要么都不发生。
(2)一致性(Consistency) 事务必须使数据库从一个一致性状态变换到另外一个一致性状态。
(3)隔离性(Isolation) 事务的隔离性是指一个事务的执行不能被其他事务干扰,即一个事务内部的操作及使用的数据对并发的其他事务是隔离的,并发执行的各个事务之间不能互相干扰。
(4)持久性(Durability) 持久性是指一个事务一旦被提交,它对数据库中数据的改变就是永久性的,接下来的其他操作和数据库故障不应该对其有任何影响
12.2 事务的开启、提交、回滚
MySQL默认情况下是自动提交事务。 每一条语句都是一个独立的事务,一旦成功就提交了。一条语句失败,单独一条语句不生效,其他语句是生效的。
12.2.1 手动提交模式
#开启手动提交事务模式
set autocommit = false;  或  set autocommit = 0;

上面语句执行之后,它之后的所有sql,都需要手动提交才能生效,直到恢复自动提交模式。

#恢复自动提交模式
set autocommit = true; 或 set autocommit = 1;
例如:
SET autocommit = FALSE;#设置当前连接为手动提交模式

UPDATE t_employee SET salary = 15000
WHERE ename = '孙红雷';

COMMIT;#提交
例如:
SET autocommit = FALSE;#设置当前连接为手动提交模式

UPDATE t_employee SET salary = 15000
WHERE ename = '孙红雷';

#后面没有提交,直接关了连接,那么这句修改没有生效
12.2.2 自动提交模式下开启事务
/*
也可以在自动提交模式下,开启一个事务。
(1)start transaction;

....

(3)commit; 或 rollback;
在(1)和(3)之间的语句是属于手动提交模式,其他的仍然是自动提交模式。
*/

START TRANSACTION; #开始事务

UPDATE t_employee SET salary = 0
WHERE ename = '李冰冰';

#下面没有写commit;那么上面这句update语句没有正式生效。
commit;#提交

START TRANSACTION;
DELETE FROM t_employee;
ROLLBACK; #回滚
12.2.3 DDL语句不支持事务
#说明:DDL不支持事务
#DDL:create,drop,alter等创建库、创建表、删除库、删除表、修改库、修改表结构等这些语句不支持事务。
#换句话只对insert,update,delete语句支持事务。
TRUNCATE 表名称; 清空整个表的数据,不支持事务。 把表drop掉,新建一张表。

START TRANSACTION;
TRUNCATE t_employee;
ROLLBACK; #回滚  无效
12.3 事务的隔离级别
/*
mysql支持四个隔离级别:
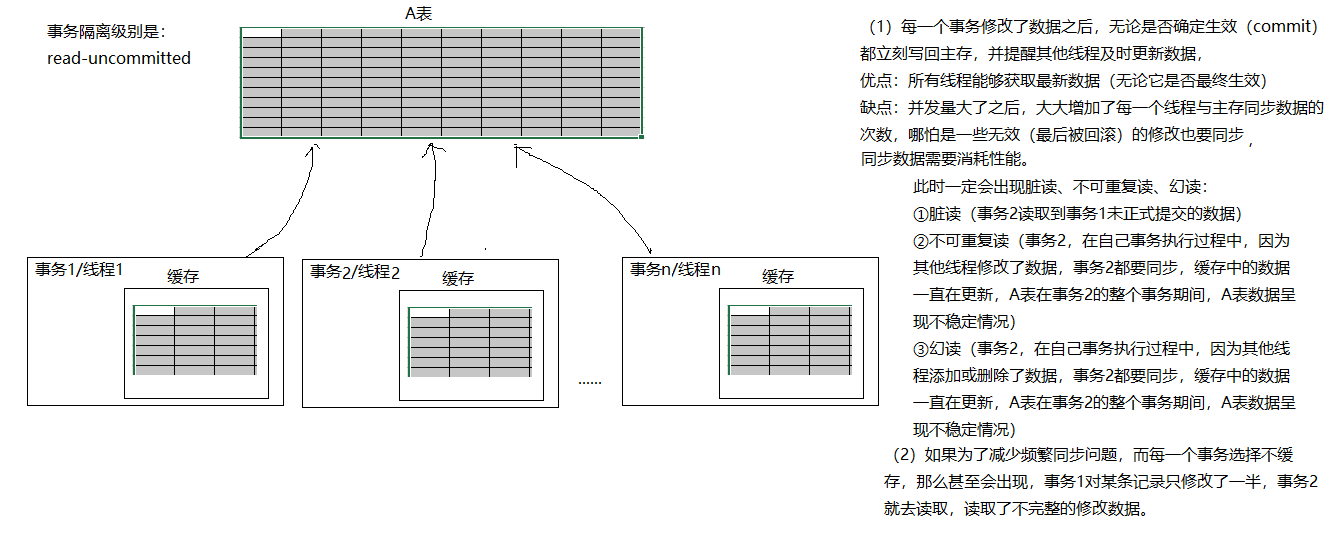
read-uncommitted:会出现脏读、不可重复读、幻读
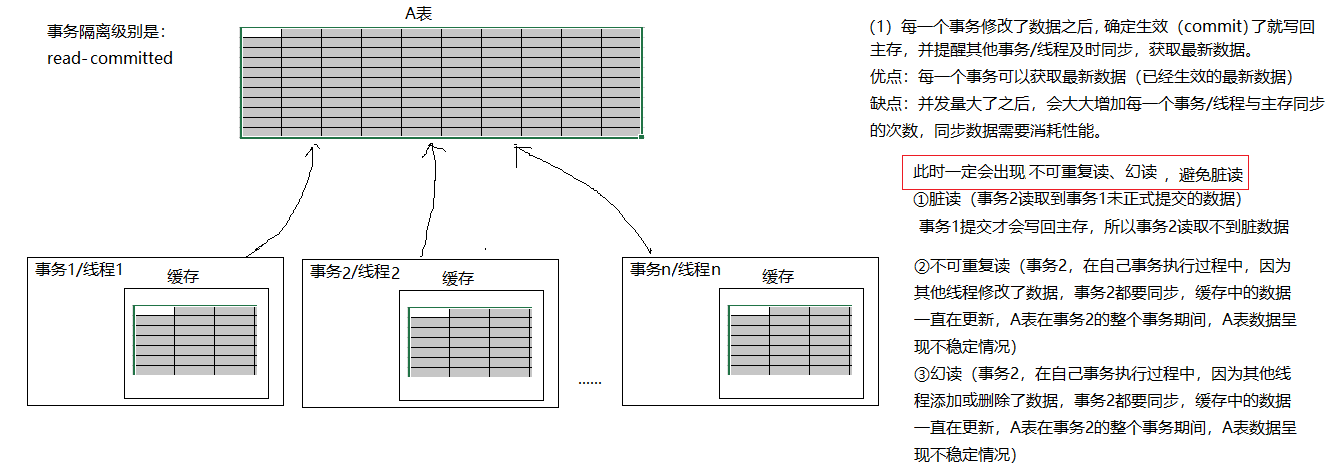
read-committed:可以避免脏读,会出现不可重复读、幻读
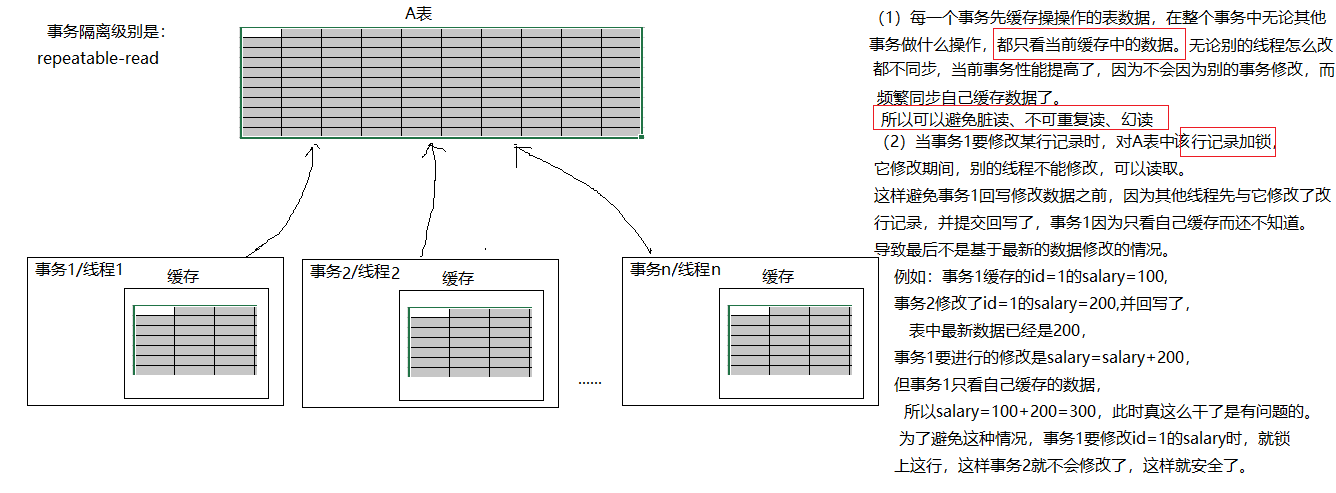
repeatable-read:可以避免脏读、不可重复读、幻读。但是两个事务不能操作(写update,delete)同一个行。
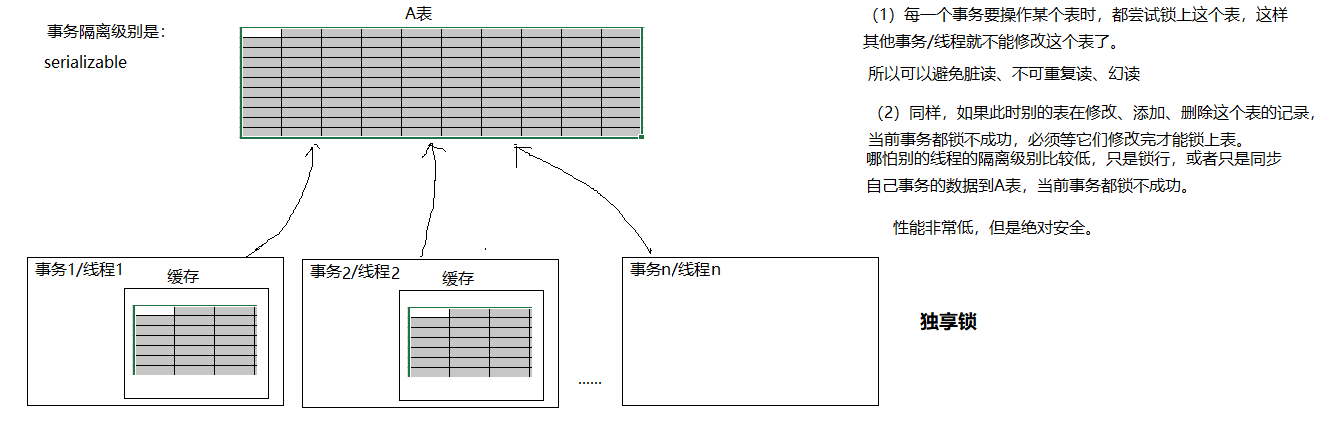
serializable:可以避免脏读、不可重复读、幻读。但是两个事务不能操作(写update,delete)同一个表。

修改隔离级别:
set transaction_isolation='隔离级别';
#mysql8之前 transaction_isolation变量名是 tx_isolation

查看隔离级别:
select @@transaction_isolation;
*/
数据库事务的隔离性:数据库系统必须具有隔离并发运行各个事务的能力, 使它们不会相互影响, 避免各种并发问题。**一个事务与其他事务隔离的程度称为隔离级别。**数据库规定了多种事务隔离级别, 不同隔离级别对应不同的干扰程度, 隔离级别越高, 数据一致性就越好, 但并发性越弱。
- 脏读:一个事务读取了另一个事务未提交数据;
- 不可重复读:同一个事务中前后两次读取同一条记录不一样。因为被其他事务修改了并且提交了。
- 幻读:一个事务读取了另一个事务新增、删除的记录情况,记录数不一样,像是出现幻觉。
数据库提供的 4 种事务隔离级别:
| 隔离级别 | 描述 |
|---|---|
| read-uncommitted | 允许A事务读取其他事务未提交和已提交的数据。会出现脏读、不可重复读、幻读问题 |
| read-committed | 只允许A事务读取其他事务已提交的数据。可以避免脏读,但仍然会出现不可重复读、幻读问题 |
| repeatable-read | 确保事务可以多次从一个字段中读取相同的值。在这个事务持续期间,禁止其他事务对这个字段进行更新。可以避免脏读和不可重复读。但是幻读问题仍然存在。注意:mysql中使用了MVCC多版本控制技术,在这个级别也可以避免幻读。 |
| serializable | 确保事务可以从一个表中读取相同的行,相同的记录。在这个事务持续期间,禁止其他事务对该表执行插入、更新、删除操作。所有并发问题都可以避免,但性能十分低下。 |
- Oracle 支持的 2 种事务隔离级别:READ-COMMITED, SERIALIZABLE。 Oracle 默认的事务隔离级别为: READ COMMITED 。
- Mysql 支持 4 种事务隔离级别。 Mysql 默认的事务隔离级别为: REPEATABLE-READ。在mysql中REPEATABLE READ的隔离级别也可以避免幻读了。
第13章 用户管理
13.1 查看用户
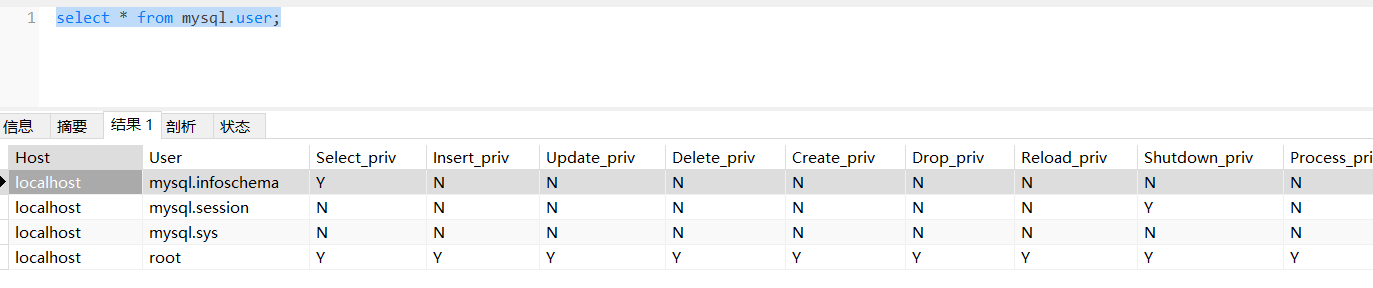
MySQL中的用户和权限都保存在mysql系统库相应的数据表中。MySQL服务器通过权限表来控制用户对数据库的访问,由MySQL_install_db脚本初始化。存储账户权限信息的表主要有user、db、host、tables_priv、columns_priv和procs_priv。
- user表:存储连接MySQL服务的账户信息,账户对全局有效;
- db表:存储用户对某个具体数据库的操作权限;
- tables_priv表:存储用户对某个数据表的操作权限;
- columns_priv表:存储用户对数据表的某一列的操作权限;
- procs_priv表:存储用户对存储过程和函数的操作权限。
select * from mysql.user;
# 用户管理

# 创建用户

drop user 'zhaosi';

create user 'zhaosi';

# 创建用户并且指定密码

create user 'zhaosi' identified by 'admin9999';


# 授权
grant select,delete,update,insert on java1209.* to 'zhaosi';


# 授权 给zhaosi用户 查询和 添加权限  针对于  dep表
grant select,insert on java1224.dep to 'zhaosi';

# 删除用户

drop user 'zhaosi';

# 撤销权限
revoke delete,update on java1209.employee from 'zhaosi';
13.2 用户管理
创建、删除用户,以及为用户授权和撤销权限等sql(略)。请看可视化工具笔记。
第14章 MySQL8的部分新特性
14.1.系统表全部为InnoDB表
从 MySQL 8.0 开始,mysql 系统表和数据字典表使用 InnoDB 存储引擎,存储在 MySQL 数据目录下的 mysql.ibd 表空间文件中。在 MySQL 5.7 之前,这些系统表使用 MyISAM 存储引擎,存储在 mysql 数据库文件目录下各自的表空间文件中。关于数据库存储引擎的详细内容,在MySQL高级课程讲解。
在MySQL5.7版本中查看系统表类型,结果如下:
mysql> #MySQL5.7
mysql> #查看系统表类型
mysql> SELECT DISTINCT(ENGINE) FROM information_schema.tables;
+----------------------+
| ENGINE             		|
+----------------------+
| MEMORY             		|
| InnoDB             		|
| MyISAM             		|
| CSV                		|
| PERFORMANCE_SCHEMA 	|
| NULL               		|
+----------------------+
6 rows in set (0.04 sec)
在MySQL8.0版本中查看系统表类型,结果如下:
mysql> #MySQL8.0
mysql> #查看系统表类型
mysql> SELECT DISTINCT(ENGINE) FROM information_schema.tables;
+--------------------+
| ENGINE                |
+--------------------+
| InnoDB                |
| NULL                  |
| PERFORMANCE_SCHEMA |
| CSV                   |
+--------------------+
4 rows in set (0.00 sec)
系统表全部换成事务型的InnoDB表,默认的MySQL实例将不包含任何MyISAM表,除非手动创建MyISAM表。
14.2.默认字符集改为utf8mb4
在8.0版本之前,MySQL默认的字符集为Latin1,而8.0版本默认字符集为utf8mb4。
Latin1是ISO-8859-1的别名,有些环境下写作Latin-1。ISO-8859-1编码是单字节编码,不支持中文等多字节字符,但向下兼容ASCII。
MySQL中utf8字符集,它是utf8mb3的别称,使用三个字节编码表示一个字符。自MySQL4.1版本被引入,能够支持绝大多数语言的字符,但依然有些字符不能正确编码,如emoji表情字符等,为此MySQL5.5引入了utf8mb4字符集。在MySQL5.7对utf8mb4进行了大幅优化,并丰富了校验字符集。mb4就是“most byte 4”的意思,专门用来兼容四字节的Unicode,utf8mb4编码是utf8编码的超集,兼容utf8,并且能存储4字节的表情字符。如果原来某些库和表的字符集是utf8,可以直接修改为utf8mb4,不需要做其他转换。但是从uft8mb4转回utf8就会有问题。
使用SHOW语句查看MySQL5.7版本数据库的默认编码。
mysql> #查看MySQL5.7数据库的默认编码
mysql> SHOW VARIABLES LIKE 'character_set_database';
+------------------------+--------+
| Variable_name            | Value  |
+------------------------+--------+
| character_set_database | latin1 |
+------------------------+--------+
1 row in set, 1 warning (0.00 sec)
使用SHOW语句查看MySQL8.0版本数据库的默认编码。
mysql> #查看MySQL8.0数据库的默认编码
mysql> SHOW VARIABLES LIKE 'character_set_database';
+------------------------+---------+
| Variable_name            | Value   |
+------------------------+---------+
| character_set_database | utf8mb4 |
+------------------------+---------+
1 row in set, 1 warning (0.00 sec)
字符集校对规则是在字符集内用于字符比较和排序的一套规则,比如有的规则区分大小写,有的则无视。校对规则特征:
- 两个不同的字符集不能有相同的校对规则。
- 每个字符集有一个默认校对规则。
- 校对规则存在命名约定,以其相关的字符集名开始,中间包括一个语言名,并且以_ci、_cs或_bin结尾。其中_ci表示大小写不敏感、_cs表示大小写敏感、bin表示直接比较字符的二进制编码,即区分大小写。
使用SHOW语句查看utf8mb4字符集的部分校对规则如下:
mysql> SHOW COLLATION LIKE 'utf8mb4_0900%';
+-----------+---------+-----+---------+----------+---------+--------------+
| Collation  | Charset | Id  | Default | Compiled | Sortlen | Pad_attribute|
+-------------------+---------+-----+---------+----------+-------+--------+
|utf8mb4_0900_ai_ci	| utf8mb4 | 255 | Yes    | Yes     |   0 | NO PAD        	|
|utf8mb4_0900_as_ci	| utf8mb4 | 305 |         | Yes     |   0 | NO PAD        	|
|utf8mb4_0900_as_cs	| utf8mb4 | 278 |         | Yes     |   0 | NO PAD        	|
|utf8mb4_0900_bin	| utf8mb4 | 309 |         | Yes     |   1 | NO PAD        	|
+-------------------+---------+-----+---------+----------+---------+------+
4 rows in set (0.00 sec)
14.3.支持检查约束(见上面检查约束)
14.4.支持窗口函数(见上面窗口函数)
14.5.用户管理
在MySQL 8.x中,默认的身份认证插件是“caching_sha2_password”,替代了之前的“mysql_native_password”。可以通过系统变量default_authentication_plugin和mysql数据库中的user表来看到这个变化。
在MySQL8之前默认的身份插件是“mysql_native_password”,即MySQL用户的密码使用PASSWORD函数进行加密。在MySQL 8.x中,默认的身份认证插件是“caching_sha2_password”,替代了之前的“mysql_native_password”,PASSWORD函数被弃用了。
在MySQL版本5.6.6版本起,在mysql.user表中添加了“password_expired”字段,它允许设置密码是否失效。如果“password_lifetime”字段值不为NULL,那么从MySQL服务启动时间开始,经过“password_lifetime”字段值的时间间隔之后,密码就过期了,即“password_expired”字段就为“Y”。任何密码超期的账号想要连接服务器端进行数据库操作都必须更改密码。MySQL8.0版本允许数据库管理员手动设置账户密码过期时间。
从MySQL 8.x版本开始允许限制重复使用以前的密码。
在MySQL8之前,如果要给多个用户授予相同的角色,需要为每个用户单独授权。在MySQL8之后,可以为多个用户赋予统一的角色,然后给角色授权即可,角色可以看成是一些权限的集合,这样就无须为每个用户单独授权。如果角色的权限修改,将会使得该角色下的所有用户的权限都跟着修改,这就非常方便。
mysql的密码字段有变化:
-
mysql5.7之前mysql系统库的user表,密码字段名是password
-
mysql5.7版本mysql系统库的user表,密码字段名是authentication_string
-
mysql8.0版本mysql系统库的user表,密码字段名是authentication_string,另外用户管理还有角色概念,mysql系统库中有default_roles表。
14.6.其他新特性(略)
通用表达式、计算列、DDL操作支持原子性、数据字典合并等等。
通用表达式简称为CTE(Common Table Expressions)。CTE是命名的临时结果集,作用范围是当前语句。CTE可以理解为一个可以复用的子查询,但是和子查询又有区别,一个CTE可以引用其他CTE,CTE还可以是自引用(递归CTE),也可以在同一查询中多次引用,但子查询不可以。
WITH [RECURSIVE]
 cte_name [(col_name [, col_name] ...)] AS (subquery)
 [, cte_name [(col_name [, col_name] ...)] AS (subquery)] ...
通用表达式以“WITH”开头,如果“WITH”后面加“RECURSIVE”就表示接下来在通用表达式中需要递归引用自己,否则就不递归引用。每一个通用表达式都需要有一个名字,它相当于是子查询结果集的名字。
#(1)在“t_employee”表中查询每个人薪资和公司平均薪资的的差值。
WITH temp AS (SELECT ROUND(AVG(salary),2) AS pingjun FROM t_employee)
SELECT ename AS "员工姓名",
    salary AS "薪资",
    pingjun "公司平均薪资",
    ROUND(salary - pingjun,2) "差值"
FROM t_employee,temp
HAVING ABS(差值)>5000;

#(2)查询薪资低于9000的员工编号,员工姓名,员工薪资,领导编号,领导姓名,领导薪资
WITH
emp AS (SELECT eid,ename,salary,`mid` FROM t_employee WHERE salary <9000),
mgr(meid,mename,msalary) AS (SELECT eid,ename,salary FROM t_employee)

SELECT eid AS "员工薪资",
	ename AS "员工姓名",
	salary AS "员工薪资",
	meid AS "领导编号",
	mename AS "领导姓名",
	msalary AS "领导薪资"
FROM emp INNER JOIN mgr ON emp.mid = mgr.meid;

#(3)查询eid为21的员工,和他所有领导,直到最高领导。
CREATE TABLE emp AS (SELECT eid,ename,salary,tel,`mid` FROM t_employee WHERE salary < 10000);
UPDATE emp SET MID=19 WHERE eid=21;
UPDATE emp SET MID=17 WHERE eid=19;
UPDATE emp SET MID=16 WHERE eid=17;
UPDATE emp SET MID=15 WHERE eid=16;
UPDATE emp SET MID=4 WHERE eid=15;
UPDATE emp SET MID=NULL WHERE eid=4;
SELECT * FROM emp;


WITH RECURSIVE cte
AS (
	SELECT eid,ename,`mid`
 	FROM emp
 	WHERE eid = 21

UNION ALL

 	SELECT emp.eid,emp.ename,emp.mid
 	FROM emp INNER JOIN cte
 	ON emp.eid = cte.mid
 	WHERE emp.eid IS NOT NULL
)
SELECT * FROM cte;