
掌柜智库项目全流程汇总文档
1. 项目整体概述
1.1 项目定位
掌柜智库是一个企业级智能知识库系统,基于 RAG(检索增强生成) 技术,为垂直领域(电子产品手册、维修指南、技术文档等)提供精准、智能的知识检索与问答服务。
1.2 核心目标
- 将非结构化文档(PDF、Markdown)转化为可检索的结构化知识
- 通过多路召回策略提升检索准确率(向量检索 + HyDE + Web搜索)
- 提供流畅的流式问答交互体验(SSE实时推送)
1.3 系统架构
| 层级 | 职责 | 技术实现 |
|---|---|---|
| API层 | HTTP接口暴露、请求路由 | FastAPI + Uvicorn |
| Processor层 | 业务流程编排、节点调度 | LangGraph |
| Utils层 | 工具函数封装、外部服务调用 | Python模块 |
| 数据层 | 数据持久化、检索 | Milvus / MongoDB / MinIO |
1.4 两大核心管线
| 管线 | 职责 | 覆盖文档 |
|---|---|---|
| 管线A:离线导入管线 | 文档导入 → 知识库构建 | 文档03~10 |
| 管线B:在线检索管线 | 用户问答 → 检索链路 | 文档11~20 |
1.5 核心功能特性
| 功能模块 | 描述 |
|---|---|
| 文档智能导入 | 支持PDF/Markdown上传,自动解析、切分、向量化 |
| 混合向量检索 | 稠密向量 + 稀疏向量(BM25)混合检索 |
| 多路召回融合 | 向量检索 + HyDE + Web搜索 |
| 智能重排序 | Reranker模型重排序,断崖检测动态截断 |
| 流式问答 | SSE实时推送,逐字输出答案 |
| 会话历史管理 | MongoDB存储对话历史,支持上下文连续对话 |
2. 项目环境与依赖准备
2.1 服务器环境
| 组件 | 配置项 | 说明 |
|---|---|---|
| CentOS 7 | 虚拟机 | CPU: 2x2, 内存: 4G, 磁盘: 40G |
| Docker | CE社区版 | 用于部署中间件容器 |
| 网络 | 静态IPv4 | IP: 192.168.100.100, 关闭firewalld防火墙 |
2.2 中间件清单
| 中间件 | 版本/关键参数 | 端口 | 用途 |
|---|---|---|---|
| MinIO | RELEASE.2024-12-18T13-15-44Z | 9000(API) / 9001(Console) | 对象存储:文件与图片 |
| Milvus | v2.5.5 | 19530 | 向量数据库:存储和检索文档向量 |
| MongoDB | 最新版 | 27017 | 文档数据库:存储对话历史 |
| Attu | - | 7000 | Milvus可视化管理工具 |
2.3 AI/ML模型清单
| 模型/框架 | 用途 | 说明 |
|---|---|---|
| DashScope(Qwen) | 大语言模型 | qwen-flash(默认LLM) / qwen3-vl-flash(视觉模型) |
| text-embedding-v4 | 云端嵌入向量 | 1536维,通过OpenAI兼容接口调用 |
| BGE-M3 | 本地混合向量嵌入 | 1024维稠密 + 稀疏向量(BM25风格) |
| BGE-Reranker-Large | 本地重排序模型 | Cross-Encoder交叉编码器 |
| MinerU | PDF解析 | 云端API,异步轮询模式 |
| MCP WebSearch | 联网搜索 | 百炼MCP服务,SSE协议 |
2.4 Python环境
| 工具/库 | 用途 |
|---|---|
| uv | Python包管理,替代pip/poetry |
| Python 3.11 | 解释器版本 |
| PyTorch (CUDA 12.8) | 深度学习框架,支撑BGE-M3推理 |
| FlagEmbedding | BGE-M3模型运行库 |
| pymilvus[model] | Milvus Python SDK |
| LangChain / LangGraph | LLM应用框架和工作流编排 |
2.5 核心环境变量(.env文件分类)
# MinerU API
MINERU_API_TOKEN / MINERU_BASE_URL

# LLM API(DashScope兼容)
OPENAI_API_KEY / OPENAI_API_BASE / LLM_DEFAULT_MODEL / VL_MODEL / ITEM_MODEL

# BGE模型
BGE_M3_PATH / BGE_DEVICE / BGE_FP16 / BGE_RERANKER_LARGE

# Embedding
EMBEDDING_DIM=1536 / EMBEDDING_MODEL=text-embedding-v4

# Milvus
MILVUS_URL / CHUNKS_COLLECTION=kb_chunks / ITEM_NAME_COLLECTION=kb_item_names

# MongoDB
MONGO_URL / MONGO_DB_NAME=kb001

# MinIO
MINIO_ENDPOINT / MINIO_ACCESS_KEY / MINIO_SECRET_KEY / MINIO_BUCKET_NAME

# MCP联网搜索
MCP_DASHSCOPE_BASE_URL
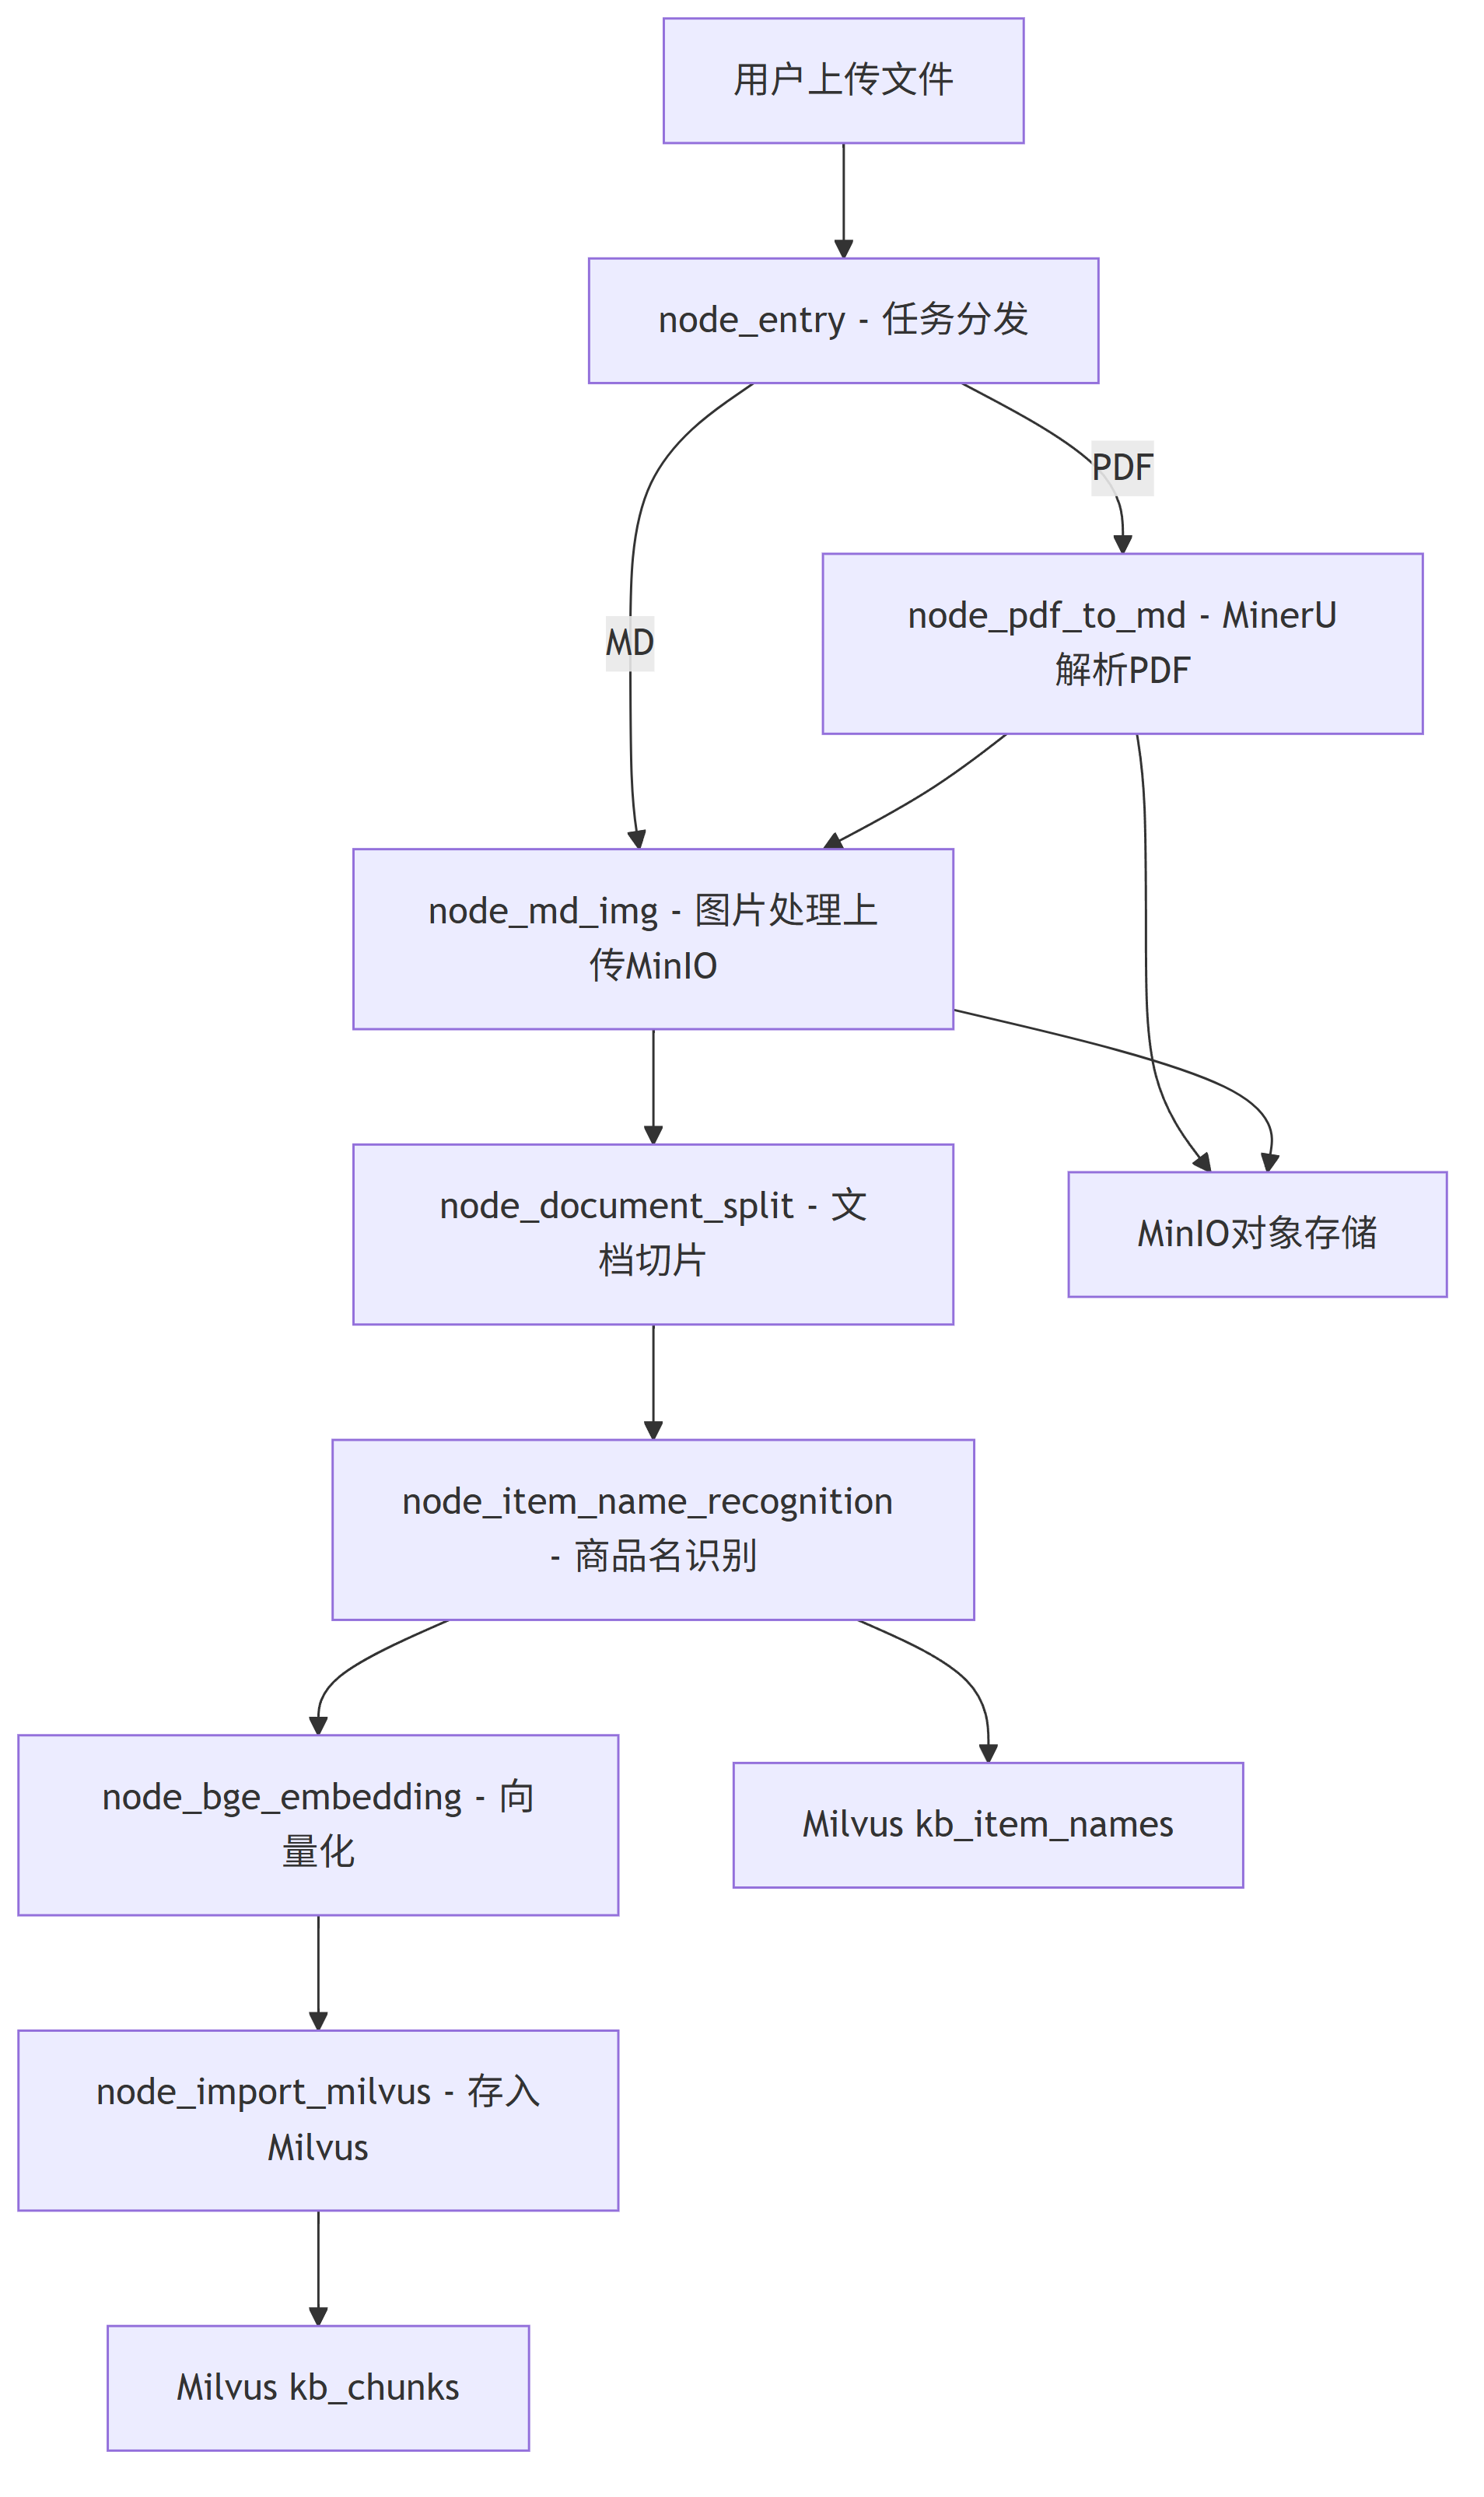
3. 离线管线:文档导入构建知识库(文档03~10)
3.1 管线整体流程图

3.2 骨架代码与基础模块(文档03)
3.2.1 模块结构
processor/import_processor/
├── config.py        # 配置管理(单例模式)
├── exceptions.py    # 自定义异常层级
├── state.py         # 图状态类型定义(ImportGraphState)
├── base.py          # 节点基类(BaseNode)
├── main_graph.py    # 主图定义与构建(KBImportWorkflow)
└── nodes/           # 具体业务节点
    ├── node_entry.py
    ├── node_pdf_to_md.py
    ├── node_md_img.py
    ├── node_document_split.py
    ├── node_item_name_recognition.py
    ├── node_bge_embedding.py
    └── node_import_milvus.py
3.2.2 配置管理(config.py)
配置加载流程:
- 程序启动时
load_dotenv()加载.env文件 ImportConfig数据类定义所有配置字段,支持默认值 + 环境变量覆盖get_config()返回全局单例
核心配置分组及参数:
| 配置分组 | 参数名 | 默认值 | 说明 |
|---|---|---|---|
| 文档处理 | max_content_length | 2000 | 切片最大字符数 |
| 文档处理 | img_content_length | 200 | 图片上下文最大长度 |
| 文档处理 | min_content_length | 500 | 合并短内容的最小长度 |
| 文档处理 | overlap_sentences | 1 | 句子级切分重叠句数 |
| 文档处理 | item_name_chunk_k | 3 | 商品名识别使用的切片数量 |
| 文档处理 | item_name_chunk_size | 2500 | 商品名识别使用的切片内容长度 |
| 文档处理 | image_extensions | {.jpg,.jpeg,.png,.gif,.bmp,.webp} | 支持的图片扩展名 |
| 向量 | embedding_dim | 1024 | 向量维度 |
| 向量 | embedding_batch_size | 8 | 向量化批次大小 |
| 限流 | requests_per_minute | 15 | 图片总结API速率限制 |
3.2.3 异常层级(exceptions.py)
ImportProcessError (基础异常)
├── ConfigurationError      # 配置错误
├── StateFieldError          # 状态字段缺失/无效
├── FileProcessingError      # 文件处理错误
│   ├── PdfConversionError   # PDF转换错误
│   └── ImageProcessingError # 图片处理错误
├── DocumentSplitError       # 文档切分错误
├── EmbeddingError           # 向量化错误
├── LLMError                 # LLM调用错误
├── StorageError             # 存储错误
│   ├── MilvusError          # Milvus存储错误
│   └── MinioError           # MinIO存储错误
└── ValidationError          # 数据验证错误
3.2.4 图状态定义(state.py)—— ImportGraphState
流程开始时传入的数据:
{
    "import_file_path": "str   // 用户上传的原始文件路径"
}
全流程结束后的输出数据:
{
    "task_id": "str              // 任务追踪ID",
    "is_md_read_enabled": "bool  // Markdown文件标志",
    "is_pdf_read_enabled": "bool // PDF文件标志",
    "import_file_path": "str     // 原始输入文件路径",
    "file_dir": "str             // 文件输出目录",
    "pdf_path": "str             // PDF文件路径",
    "md_path": "str              // Markdown文件路径",
    "file_title": "str           // 文件标题(不含扩展名)",
    "item_name": "str            // 识别出的商品/产品名称",
    "md_content": "str           // Markdown文档内容",
    "chunks": "List              // 文档切片列表(含向量)"
}
3.2.5 节点基类(base.py)—— BaseNode
核心设计模式:模板方法模式
__call__(state)          # 入口:统一日志 + 异常包装
    ├── 日志记录开始
    ├── process(state)   # 抽象方法,子类实现具体业务逻辑
    └── 日志记录结束/异常包装抛出
统一功能:
- 日志记录器命名:
import.{self.name} - 配置注入:从全局单例获取
- 异常包装:所有异常统一包装为
ImportProcessError,携带节点名 + 原始异常链
3.2.6 主图(main_graph.py)—— KBImportWorkflow
条件路由规则(route_after_entry):
is_pdf_read_enabled=True→node_pdf_to_mdis_md_read_enabled=True→node_md_img- 其他 →
END
节点执行顺序:
node_entry → (条件路由) → node_pdf_to_md → node_md_img → node_document_split → node_item_name_recognition → node_bge_embedding → node_import_milvus → END
3.3 节点1:入口节点(文档04)—— node_entry
① 核心功能说明
任务分发节点:检测上传文件类型,提取文件标题,为后续路由提供状态标记。
② 输入数据(本节点收到的)
{
    "import_file_path": "str  // 用户上传的文件完整路径(必填)"
}
③ 输出数据(本节点传出的)
{
    "is_pdf_read_enabled": "bool     // 是否为PDF文件",
    "is_md_read_enabled": "bool      // 是否为Markdown文件",
    "pdf_path": "str                 // PDF文件路径(PDF时设置)",
    "md_path": "str                  // MD文件路径(MD时设置)",
    "file_title": "str               // 文件标题(不含扩展名)"
}
④ 核心业务规则
| 场景 | 处理方式 | 异常类型 |
|---|---|---|
import_file_path 为空 | 抛出异常 | StateFieldError |
| 文件物理不存在 | 抛出异常 | FileProcessingError |
后缀为 .pdf | 设置 is_pdf_read_enabled=True, pdf_path=import_file_path | - |
后缀为 .md | 设置 is_md_read_enabled=True, md_path=import_file_path | - |
| 其他扩展名 | 抛出异常 | ValidationError |
| 提取标题 | file_title = Path(path).stem(不含扩展名) | - |
⑤ 前置依赖
- 无前置节点依赖,是流程起点
3.4 节点2:PDF转Markdown节点(文档05)—— node_pdf_to_md
① 核心功能说明
调用MinerU云端API将PDF文档解析为结构化Markdown格式(含图片引用),解决非结构化PDF难以直接处理的痛点。
② 输入数据(本节点收到的)
{
    "pdf_path": "str   // PDF文件路径(来自node_entry)",
    "file_dir": "str   // 输出目录(可选,默认PDF所在目录)"
}
③ 输出数据(本节点传出的)
{
    "md_path": "str      // 转换后的Markdown文件路径",
    "md_content": "str   // Markdown文档内容(读入内存)"
}
④ 核心业务规则与处理流程
▸ 步骤1:校验路径
- 校验
pdf_path和file_dir非空 - 校验PDF文件是否存在
- 输出目录不存在则自动递归创建
▸ 步骤2:上传与轮询(核心——异步API设计)
1. 申请上传链接:POST /file-urls/batch
   请求参数:{"files":[{"name":"文件名"}], "model_version":"vlm"}
   响应:含 signed_url(签名上传URL)+ batch_id(任务批次ID)

2. 上传文件:PUT signed_url(二进制流上传)

3. 轮询解析结果:GET /extract-results/batch/{batch_id}
   轮询参数:timeout=600s(超时), poll_interval=3s(间隔)
   状态值:done(完成) / failed(失败) / processing(处理中)

4. 成功后返回:full_zip_url(ZIP包下载链接)
▸ 步骤3:下载与解压
- 下载ZIP包 → 解压到目标目录 → 找到
full.md→ 重命名为{pdf_stem}.md
关键参数:
| 参数 | 值 | 说明 |
|---|---|---|
timeout_seconds | 600 | 轮询最大超时时长(秒) |
poll_interval | 3 | 轮询间隔(秒) |
model_version | "vlm" | MinerU解析模型版本 |
MinerU API配置:
MINERU_API_TOKEN=xxx
MINERU_BASE_URL=https://mineru.net/api/v4
⑤ 前置依赖
node_entry已设置pdf_path- MinerU API服务可用
3.5 节点3:MD图片处理节点(文档06)—— node_md_img
① 核心功能说明
对Markdown文档中的图片进行"多模态语义对齐":将图片上传到MinIO对象存储,并调用多模态大模型(qwen3-vl-flash)为每张图片生成中文摘要,填入Markdown图片的Alt文本中。
② 输入数据(本节点收到的)
{
    "md_path": "str      // Markdown文件路径",
    "md_content": "str   // Markdown文档内容(含本地图片引用)"
}
③ 输出数据(本节点传出的)
{
    "md_content": "str   // 处理后的Markdown内容(图片路径已替换为MinIO URL,Alt文本已填充摘要)",
    "md_path": "str      // 新保存的Markdown文件路径(_new.md)"
}
④ 核心业务规则与处理流程
▸ 步骤1:初始化
- 从state获取
md_path、md_content - 图片目录路径:MD文件同级目录下的
images文件夹 - 如果
images目录不存在,跳过图片处理
▸ 步骤2:扫描图片
- 遍历
images目录,过滤支持格式(jpg/jpeg/png/gif/bmp/webp) - 正则匹配MD内容中实际引用了的图片
- 对每张匹配到的图片,截取前后各100字符作为上下文
▸ 步骤3:生成图片摘要(核心)
VLM调用参数:
{
    "model": "qwen3-vl-flash",
    "base_url": "https://dashscope.aliyuncs.com/compatible-mode/v1",
    "temperature": 0.1
}
提示词结构:
这是"{文件标题}"文件中的一张图片,
图片上文部分为"{前文}",下文部分为"{后文}",
请用中文简要总结这张图片的内容,用于Markdown图片标题。
速率控制——滑动窗口令牌桶算法:
| 参数 | 值 | 说明 |
|---|---|---|
max_requests | 10 | 1分钟窗口内最大请求数 |
window_seconds | 60 | 滑动窗口时长 |
| 触发等待 | 请求数 ≥ max_requests | 等待至最早请求过期 |
▸ 步骤4:上传至MinIO并替换MD引用
MinIO操作:
- 上传目录:
upload-images/{文档名}(按文档隔离) - 上传前幂等清理:删除同目录旧文件
- 上传方法:
fput_object(文件流上传) - 存储桶策略:设置为Public Read(匿名可读,无需预签名URL)
- 构造URL:
http://{endpoint}/{bucket_name}/{object_name}
MD替换规则:
替换前:
替换后:
▸ 步骤5:备份保存
- 新文件命名为
{原文件名}_new.md - 原文件不变(避免数据丢失)
⑤ 前置依赖
- Markdown文件已存在(来自
node_pdf_to_md或直接上传的MD) - MinIO服务可用
- VLM模型API可用
⑥ 持久化存储
| 存储位置 | 存储内容 |
|---|---|
| MinIO | knowledge-base 桶下 upload-images/{文档名}/ 存放图片文件 |
| 本地磁盘 | _new.md 文件保存处理后的Markdown内容 |
3.6 节点4:文档切片节点(文档07)—— node_document_split
① 核心功能说明
将长文档切分为适合向量检索的语义单元(Chunk)。采用 "按标题结构切分 + 超长二次切分 + 过短合并" 的三层策略,平衡语义完整性 和 检索精确度。
② 输入数据(本节点收到的)
{
    "md_content": "str     // Markdown文档内容(来自node_md_img)",
    "file_title": "str     // 文件标题(来自node_entry)"
}
③ 输出数据(本节点传出的)
{
    "chunks": [
        {
            "title": "str           // 切片标题(MD标题或"无标题"/"标题-序号")",
            "content": "str         // 切片内容",
            "file_title": "str      // 所属文件标题",
            "parent_title": "str    // 父级标题(用于Milvus schema适配)",
            "part": "int            // 子Chunk序号(超长切分时)"
        }
    ]
}
④ 核心业务规则与处理流程
▸ 步骤1:输入预处理
- 非空校验:
file_title和md_content - 换行符统一:
\r\n/\r→\n(跨平台兼容)
▸ 步骤2:按MD标题初切(核心)
标题识别规则:
- 正则:
^\s*#{1,6}\s+.+(1-6级标题) - 代码块中标题跳过:识别 ``` 和 ~~~ 代码块边界(至少3个连续反引号/波浪线)
- 遇到新标题时,将上一个标题及其内容写入
sections列表 - 每个章节格式:
{title, content, file_title}
代码块识别改进(v2):
- 精确匹配代码块结束标记(相同字符+相同长度)
- 支持 ````、
~~~~等多字符代码块标记
▸ 步骤3:无标题兜底
- 如果未识别到任何标题(title_count=0),将全文作为单章节处理
- 标题设为"无标题"
▸ 步骤4:精细化处理(长切短合)
阶段4-1:切分超长章节
| 参数 | 默认值 | 说明 |
|---|---|---|
max_content_length | 2000 | 切片最大字符数 |
- 内容长度 ≤
max_content_length→ 保留原样 - 内容长度 >
max_content_length→ 递归切分 - 分隔符优先级(从粗到细):
\n\n(段落) →\n(行) →。!?;.!?;(句子) →(空格) → 硬切 - 使用
RecursiveCharacterTextSplitter(LangChain工具) - 子Chunk标题格式:
{parent_title}-{序号}
阶段4-2:合并过短章节
| 参数 | 默认值 | 说明 |
|---|---|---|
min_content_length | 500 | 合并短内容的最小长度 |
合并条件(同时满足):
- 当前块内容长度 <
min_content_length - 当前块与下一块
parent_title相同(同属一个原章节) - 合并前清理下一块开头的重复父标题
阶段4-3:父标题兜底
- 适配Milvus向量库schema,确保每个chunk有
parent_title字段 - 无
parent_title则用自身title,title也为空则填空字符串
▸ 步骤5:输出统计
- 在日志中输出:原始行数、最终Chunk数、首行Chunk预览
▸ 步骤6:本地JSON备份
- 备份路径:
D:/doc/{file_title}/chunks.json - 使用
json.dump(ensure_ascii=False,indent=2) - 备份失败仅记日志,不中断流程
⑤ 前置依赖
md_content和file_title已在state中设置
3.7 节点5:主体识别节点(文档08)—— node_item_name_recognition
① 核心功能说明
识别文档所属的商品/产品名称。利用LLM从文档前K个切片中提取核心实体名称,将识别结果向量化后存入Milvus的商品名称集合,为检索阶段的商品确认提供匹配基础。
② 输入数据(本节点收到的)
{
    "task_id": "str      // 任务追踪ID",
    "file_title": "str   // 文件标题",
    "chunks": "List      // 文档切片列表(来自node_document_split)"
}
③ 输出数据(本节点传出的)
{
    "item_name": "str               // 识别的商品名称",
    "chunks": "List                 // 回填了item_name的切片列表",
    (同时写入Milvus kb_item_names集合)
}
④ 核心业务规则与处理流程
▸ 步骤1:提取输入
- 非空校验:
file_title和chunks
▸ 步骤2:构建LLM上下文
| 参数 | 默认值 | 说明 |
|---|---|---|
item_name_chunk_k | 3 | 取前K个切片 |
item_name_chunk_size | 2500 | 最大上下文长度(字符) |
- 遍历前K个切片,带序号格式化
- 累计字符数超过
item_name_chunk_size时停止 - 返回截断后的最终上下文
▸ 步骤3:调用LLM识别商品名
System Prompt:
"你是一个专业的商品名称识别模型,请根据提供的信息,识别商品名称。"
User Prompt:
请从以下信息中识别出商品名称与型号:
文件名:{file_title}
正文切片:{context}

要求:
1. 返回内容最好带品牌、型号和名称的完整商品名称
2. 返回结果只包含商品名称,不要添加任何解释或其他内容
3. 如果无法识别商品名称,请返回空字符串
LLM参数:
{
    "model": "qwen-flash",
    "temperature": 0.1,
    "extra_body": {"enable_thinking": false}
}
清洗规则: 去除空格、换行、制表符、回车符
兜底策略:
- 上下文为空 → 返回
file_title - LLM返回空 → 返回
file_title - LLM异常 → 返回
file_title(保证流程不中断)
▸ 步骤4:回填数据
- 遍历所有chunks,每个chunk添加
item_name字段 - 更新
state["item_name"]和state["chunks"]
▸ 步骤5:生成商品名向量
使用 generate_embeddings(BGE-M3)生成稠密+稀疏双向量,用于后续向量检索。
向量规格:
| 向量类型 | 维度 | 说明 |
|---|---|---|
| 稠密向量(dense) | 1024 | BGE-M3固定维度,记录语义信息 |
| 稀疏向量(sparse) | 变长(键值对) | 记录关键词/特征位置信息,最大词汇表250002 |
L2归一化说明: BGE-M3模型原生支持L2归一化,输出向量长度已标准化为1,无需额外处理。
▸ 步骤6:存入Milvus(kb_item_names集合)
集合Schema(kb_item_names):
| 字段名 | 类型 | 说明 |
|---|---|---|
pk | INT64 (主键, auto_id) | 自增主键 |
file_title | VARCHAR(100) | 文件标题 |
item_name | VARCHAR(100) | 商品名称 |
dense_vector | FLOAT_VECTOR(1024) | 稠密向量(BGE-M3 1024维) |
sparse_vector | SPARSE_FLOAT_VECTOR | 稀疏向量(变长) |
索引配置:
| 索引名称 | 字段 | 索引类型 | 度量方式 | 参数 |
|---|---|---|---|---|
dense_vector_index | dense_vector | IVF_FLAT | COSINE | nlist: 128 |
sparse_vector_index | sparse_vector | SPARSE_INVERTED_INDEX | IP | inverted_index_algo: DAAT_MAXSCORE, normalize: True, quantization: none |
幂等性处理: 插入前按 item_name 删除已存在的同名数据
转义处理: 对商品名中的特殊字符(反斜杠、双引号、单引号)进行转义,防止Milvus过滤表达式解析失败
⑤ 前置依赖
- 切片数据(
chunks)已就绪 - BGE-M3模型已加载
- Milvus服务可用
⑥ 持久化存储
| 存储位置 | 集合/桶 | 存储内容 |
|---|---|---|
| Milvus | kb_item_names | 商品名称 + 稠密/稀疏向量 |
3.8 节点6:向量化节点(文档09)—— node_bge_embedding
① 核心功能说明
为所有文本切片生成BGE-M3混合向量(稠密+稀疏),将人类可读文本转化为机器可计算的向量表示。
② 输入数据(本节点收到的)
{
    "chunks": [
        {
            "item_name": "str       // 商品名称(来自主体识别节点)",
            "content": "str         // 切片内容",
            "title": "str           // 切片标题",
            "file_title": "str      // 文件标题"
        }
    ]
}
③ 输出数据(本节点传出的)
{
    "chunks": [
        {
            "item_name": "str              // 商品名称",
            "content": "str                // 切片内容",
            "title": "str                  // 切片标题",
            "file_title": "str             // 文件标题",
            "dense_vector": "List[float]   // 稠密向量(1024维)",
            "sparse_vector": "Dict         // 稀疏向量(键值对格式)"
        }
    ]
}
④ 核心业务规则
▸ 步骤1:输入校验
- chunks非空且为列表类型
▸ 步骤2:批量生成向量
| 参数 | 默认值 | 说明 |
|---|---|---|
batch_size | 5 | 每批处理数量(根据显存调整) |
文本拼接: 将 item_name 和 content 拼接,增强语义(商品名作为核心特征前置)
拼接规则:"{item_name}\n{content}"  (item_name非空时)
           "{content}"               (item_name为空时)
向量生成过程:
chunks列表 → 分批(每批5条) → 文本拼接 → BGE-M3.encode_documents() →
  ├→ 稠密向量: List[float] (1024维) → 存入chunk.dense_vector
  └→ 稀疏向量: Dict{索引:权重} → 存入chunk.sparse_vector
稀疏向量格式转换:
BGE-M3返回的稀疏向量为CSR格式(csr_array),需转换为字典格式以适配Milvus存储:
CSR格式 → 提取indices/indptr/data → 打包为{特征索引: 归一化权重}字典
⑤ 前置依赖
- chunks已包含
item_name字段 - BGE-M3模型已加载(单例)
3.9 节点7:存入Milvus节点(文档10)—— node_import_milvus
① 核心功能说明
导入流程终点。将含向量的切片数据持久化到Milvus向量数据库,构建可供即时查询的混合索引。
② 输入数据(本节点收到的)
{
    "chunks": [
        {
            "chunk_id": "int/str          // 切片ID",
            "content": "str               // 切片内容",
            "title": "str                 // 切片标题",
            "parent_title": "str          // 父级标题",
            "part": "int                  // 分片编号",
            "file_title": "str            // 源文件标题",
            "item_name": "str             // 商品名称",
            "dense_vector": "List[float]  // 稠密向量",
            "sparse_vector": "Dict         // 稀疏向量"
        }
    ]
}
③ 输出数据(本节点传出的)
{
    "chunks": [
        {
            // ... 原始字段不变 ...
            "chunk_id": "str  // Milvus回填的自增主键ID(由INT64转为字符串)"
        }
    ]
}
④ 核心业务规则与处理流程
▸ 步骤1:输入校验
- chunks非空且为列表
- 校验包含
dense_vector和sparse_vector字段 - 提取向量维度:
len(first_chunk['dense_vector'])
▸ 步骤2:准备Milvus集合
集合Schema(kb_chunks):
| 字段名 | 类型 | 说明 |
|---|---|---|
chunk_id | INT64 (主键, auto_id) | 切片自增ID |
content | VARCHAR(65535) | 切片内容 |
title | VARCHAR(100) | 切片标题 |
parent_title | VARCHAR(100) | 父标题 |
part | INT8 | 分片编号 |
file_title | VARCHAR(100) | 源文件标题 |
item_name | VARCHAR(100) | 商品名称(幂等性依据) |
sparse_vector | SPARSE_FLOAT_VECTOR | 稀疏向量 |
dense_vector | FLOAT_VECTOR(dim) | 稠密向量 |
索引配置:
| 索引名称 | 字段 | 索引类型 | 度量方式 | 参数 |
|---|---|---|---|---|
dense_vector_index | dense_vector | AUTOINDEX | COSINE | - |
sparse_inverted_index | sparse_vector | SPARSE_INVERTED_INDEX | IP | {inverted_index_algo: "DAAT_MAXSCORE", normalize: True, quantization: "none"} |
AUTOINDEX vs IVF_FLAT:
- 商品名集合(
kb_item_names)使用 IVF_FLAT(数据量小,需明确控制)- 切片集合(
kb_chunks)使用 AUTOINDEX(数据量不确定,自动选择最优索引)
▸ 步骤3:幂等清理
- 根据
file_title删除Milvus中已存在的旧切片数据 - 方法:
client.delete(collection_name, filter=f"file_title=='{file_title}'") - 对
file_title进行特殊字符转义
▸ 步骤4:批量插入与主键回填
- 预处理:补充
part字段(默认0) - 批量插入:
client.insert()一次提交所有数据 - 主键回填:将Milvus返回的自增
chunk_id(INT64)转为字符串,回填到每个chunk
⑤ 前置依赖
- 所有chunk已包含稠密+稀疏向量
- Milvus服务可用
⑥ 持久化存储
| 存储位置 | 集合 | 存储内容 |
|---|---|---|
| Milvus | kb_chunks | 切片内容 + 元数据 + 稠密/稀疏向量 |
4. 在线管线:用户问答检索全流程(文档11~20)
4.1 管线整体流程图
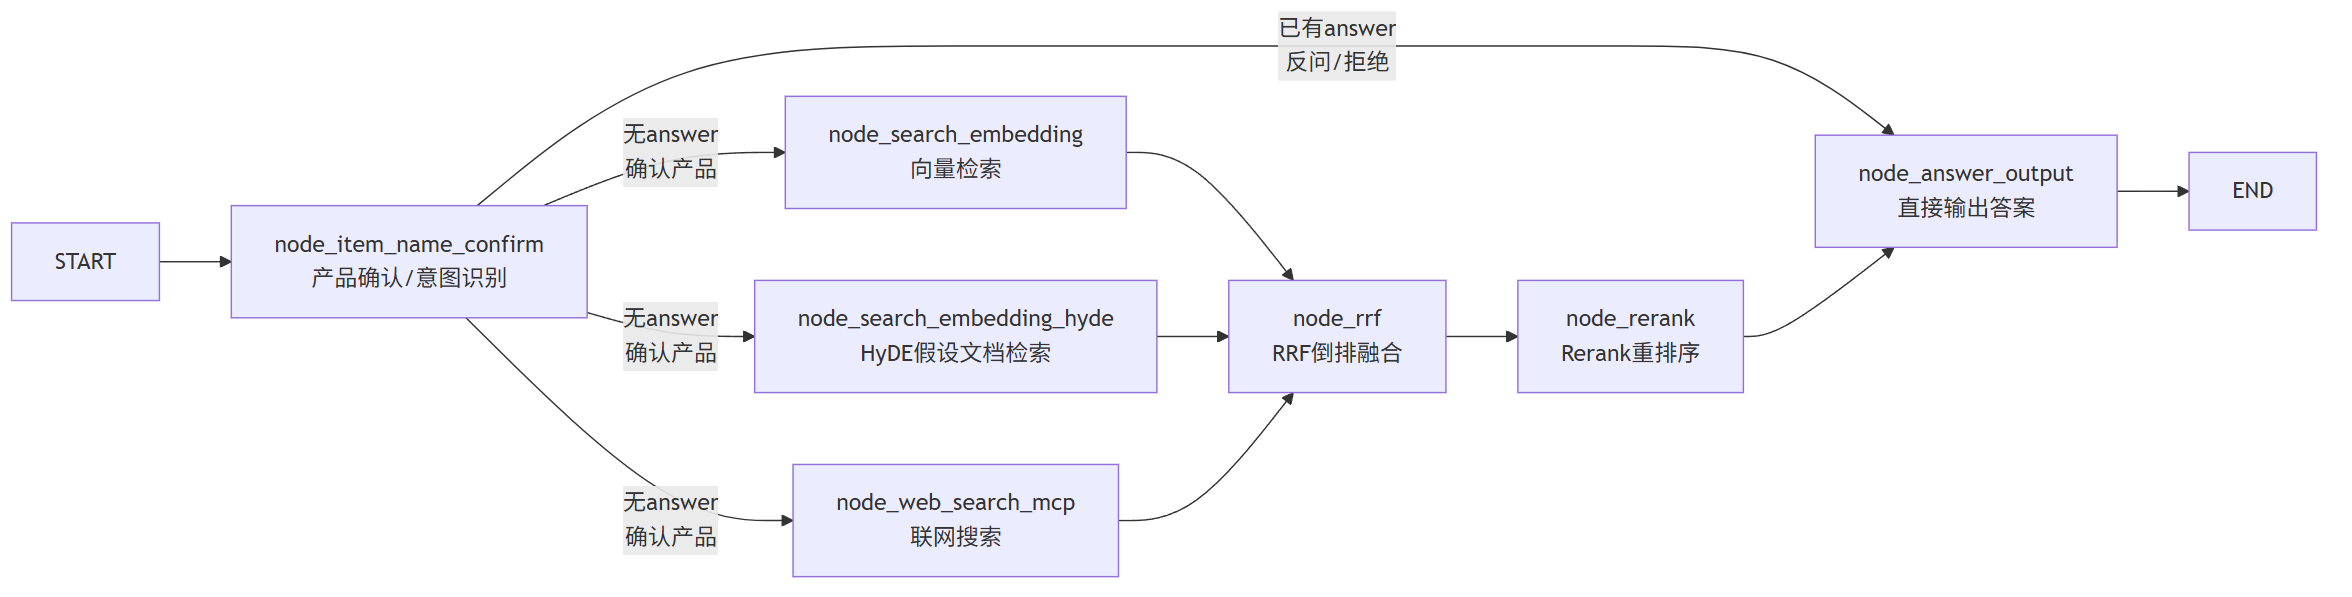
4.2 骨架代码与基础模块(文档11)
4.2.1 模块结构
processor/query_processor/
├── state.py        # 图状态定义(QueryGraphState)
├── base.py         # 节点基类(NodeBase)
├── main_graph.py   # 主图定义(KBQueryWorkflow V1/V2)
├── nodes/          # 具体业务节点
│   ├── node_item_name_confirm.py
│   ├── node_search_embedding.py
│   ├── node_search_embedding_hyde.py
│   ├── node_web_search_mcp.py
│   ├── node_rrf.py
│   ├── node_rerank.py
│   └── node_answer_output.py
└── prompt/         # 提示词模板
    ├── item_name_confirm.py
    ├── item_name_recognition.py
    ├── search_embedding_hyde.py
    └── answer_prompt.py
4.2.2 图状态定义(state.py)—— QueryGraphState
{
    "session_id": "str               // 会话ID",
    "message_id": "str               // 消息ID",
    "original_query": "str           // 用户原始问题",
    "embedding_chunks": "list        // 普通向量检索回来的切片",
    "hyde_embedding_chunks": "list   // HyDE假设性问题检索的切片",
    "web_search_docs": "list         // 网络搜索回来的文档",
    "rrf_chunks": "list              // RRF融合排序后的切片",
    "reranked_docs": "list           // 重排序后的最终Top-K文档",
    "prompt": "str                   // 组装好的Prompt",
    "answer": "str                   // 最终生成的答案",
    "item_names": "List[str]         // 提取出的商品名称",
    "rewritten_query": "str          // 改写后的独立问题",
    "history": "list                 // 历史对话记录",
    "is_stream": "bool               // 是否流式输出"
}
4.2.3 节点基类(base.py)—— NodeBase
与导入流程的 BaseNode 结构类似,但更简洁:
- 使用全局单例的
logger(来自tool.logger) __call__提供统一入口,process抛出异常时直接向上传递
4.2.4 主图V2(查询主流程)
class KBQueryWorkflowV2:
    workflow = StateGraph(QueryGraphState)

    # 注册节点
    nodes: node_item_name_confirm / node_search_embedding /
           node_search_embedding_hyde / node_web_search_mcp /
           node_rrf / node_rerank / node_answer_output

    # 路由逻辑
    route_after_item_name_confirm():
        if state.get("answer"):    # 反问/拒绝 → 直接输出
            return "node_answer_output"
        else:                      # 确认产品 → 三路并发检索
            return ["node_search_embedding",
                    "node_search_embedding_hyde",
                    "node_web_search_mcp"]

    # 边关系
    node_search_embedding → node_rrf
    node_search_embedding_hyde → node_rrf
    node_web_search_mcp → node_rrf
    node_rrf → node_rerank → node_answer_output → END
4.2.5 V1 vs V2 差异
| 特性 | V1 | V2 |
|---|---|---|
| 虚拟节点 | 有 node_multi_search + node_join | 无虚拟节点 |
| 条件路由返回 | 单字符串 | 字符串列表(直接并发分支) |
| 并发方式 | 虚拟节点分叉 | LangGraph原生并行 |
4.3 节点1:产品确认节点(文档12)—— node_item_name_confirm
① 核心功能说明
根据用户问题确认目标产品。结合历史对话提取商品名,通过向量比对进行标准化对齐。三种路由分支:有明确的商品名 → 进入检索;需要反问 → 直接输出答案;查无结果 → 直接拒绝。
② 输入数据(本节点收到的)
{
    "session_id": "str         // 会话ID",
    "original_query": "str     // 用户原始问题"
}
③ 输出数据(本节点传出的)
分支A(已确认):
{
    "session_id": "str               // 会话ID",
    "original_query": "str           // 用户原始问题",
    "history": "list                 // 历史对话记录",
    "rewritten_query": "str          // 改写后的独立完整问题",
    "item_names": "List[str]         // 已确认的标准化商品名列表",
    "answer": "str                   // 空字符串(表示无直接答案,需要检索)"
}
分支B(需反问):
{
    "answer": "str                   // 反问语句(如:"您是想问以下哪个产品:A、B、C?")",
    "item_names": "[]                // 商品名列表为空"
}
分支C(无结果):
{
    "answer": "str                   // 拒绝语句(如:"抱歉,未找到相关产品...")",
    "item_names": "[]                // 商品名列表为空"
}
④ 核心业务规则与处理流程
▸ 步骤1:参数校验
session_id和original_query非空
▸ 步骤2:读取历史会话
- 从MongoDB获取最近10条历史记录(按时间升序)
▸ 步骤3:保存当前用户消息
- 写入MongoDB,记录
session_id,role="user",text=original_query - 返回
message_id(用于后续更新)
▸ 步骤4:LLM提取商品名+问题改写(核心)
System Prompt:
"你是一个专业的客服助手,擅长理解用户意图和提取关键信息。"
User Prompt结构:
历史会话:{history_text}
当前用户问题:{query}

请提取用户正在询问的商品名称(item_names):
1. 商品名可能有多个,不能重复
2. 代词("这个"、"它")结合历史指代消解
3. 无法确定则返回空列表
4. 改写问题为包含商品名的独立完整问题

返回JSON格式:
{"item_names": ["商品A", "商品B"], "rewritten_query": "独立完整问题"}
LLM参数:
{
    "model": "qwen-flash",
    "temperature": 0.1,
    "response_format": {"type": "json_object"}
}
为什么要改写问题(rewritten_query)的三个核心原因:
| 原因 | 说明 |
|---|---|
| 修复不完美输入 | 补全口语化、模糊、错别字、信息缺失的问题 |
| 适配检索规则 | 对齐知识库术语,补充检索关键词,提升召回率 |
| 增强上下文关联 | 结合历史补全上下文,避免多轮对话检索跑偏 |
数据清洗:
- 处理LLM返回的 ````json` 代码块包裹
- 确保
item_names和rewritten_query字段存在 - 去除商品名中的空白字符
▸ 步骤5:向量化并查询Milvus
BGE-M3混合搜索流程:
item_names → generate_embeddings() → 稠密向量 + 稀疏向量
    ↓
create_hybrid_search_requests(dense, sparse, limit=5)
    ↓
hybrid_search(ranker_weights=(0.8, 0.2), norm_score=True, limit=5)
    ↓
结果:[{extracted_name, matches:[{item_name, score}]}]
混合搜索参数:
| 参数 | 值 | 说明 |
|---|---|---|
| 稠密向量权重 | 0.8 | 语义相似度 |
| 稀疏向量权重 | 0.2 | 关键词精确匹配 |
norm_score | True | 归一化评分至0~1再融合 |
limit | 5 | 每个商品名返回Top5匹配 |
| 搜索集合 | kb_item_names | Milvus商品名称集合 |
关于归一化的关键区别:
| 位置 | 归一化对象 | 目的 |
|---|---|---|
| 导入流程(存储时) | 稀疏向量本身(normalize=True) | 向量长度统一为1,IP等价余弦 |
| 检索流程(搜索时) | 搜索结果评分(norm_score=True) | 稠密/稀疏得分统一量纲再加权 |
▸ 步骤6:评分对齐策略
| 评分区间 | 判定 | 处理 |
|---|---|---|
| score > 0.85 | 确信匹配 | 直接确认,取最高分 |
| 0.6 ≤ score ≤ 0.85 | 疑似候选 | 列入候选列表(取前3个) |
| score < 0.6 | 无关/噪音 | 直接丢弃 |
▸ 步骤7:检查确认状态——三种分支
| 分支 | 条件 | 动作 |
|---|---|---|
| A: 已确认 | 存在score>0.85的已确认商品 | 更新state.item_names + 回溯更新历史消息中的item_names |
| B: 有候选 | 无已确认但有0.6~0.85的候选 | 生成反问句作为answer,中断流程 |
| C: 无结果 | 所有评分<0.6 | 生成拒识回复作为answer,中断流程 |
▸ 步骤8:写入MongoDB历史
- 分支B/C生成answer → 保存助手消息到MongoDB
- 更新用户消息:补充
rewritten_query+item_names
⑤ 前置依赖
- MongoDB服务可用
- Milvus服务可用(存储了商品名向量)
- BGE-M3模型可调用
⑥ 持久化存储
| 存储位置 | 集合 | 存储内容 |
|---|---|---|
| MongoDB | chat_message | 对话记录 {session_id, role, text, rewritten_query, item_names, image_urls, ts} |
MongoDB文档索引:
db.chat_message.createIndex([("session_id", 1), ("ts", -1)])
4.4 节点2:向量检索节点(文档13)—— node_search_embedding
① 核心功能说明
将改写后的用户问题向量化,在Milvus切片集合中进行稠密+稀疏混合检索,限定已确认的商品范围内召回Top5相关切片。
② 输入数据(本节点收到的)
{
    "rewritten_query": "str      // 改写后的完整用户问题",
    "item_names": "List[str]     // 已确认的标准化商品名列表"
}
③ 输出数据(本节点传出的)
{
    "embedding_chunks": [
        {
            "id": "int/str               // Milvus数据库ID",
            "distance": "float           // 相似度评分",
            "entity": {
                "chunk_id": "...",
                "content": "str          // 切片内容",
                "item_name": "str        // 商品名称"
            }
        }
    ]
}
④ 核心业务规则
检索流程:
1. 提取:rewritten_query + item_names
2. 向量化:generate_embeddings([query])
   → 稠密向量 + 稀疏向量
3. 构建过滤条件:'item_name in {item_names}'(限定商品范围)
4. 混合搜索:create_hybrid_search_requests(dense, sparse, expr, limit=10)
5. 执行搜索:hybrid_search(weights=(0.8, 0.2), output_fields=[chunk_id, content, item_name])
6. 返回:embedding_chunks(取res[0])
| 参数 | 值 | 说明 |
|---|---|---|
| 底层检索数(limit) | 10 | 先取10条,预留更多结果给RRF做融合 |
| 稠密权重 | 0.8 | 语义搜索权重 |
| 稀疏权重 | 0.2 | 关键词搜索权重 |
| 输出字段 | chunk_id, content, item_name | 返回的业务字段 |
| 过滤表达式 | item_name in [确认的商品名] | 限定搜索范围 |
⑤ 前置依赖
rewritten_query和item_names已确认- Milvus切片集合(
kb_chunks)已有数据 - BGE-M3模型可用
4.5 节点3:HyDE假设文档检索节点(文档14)—— node_search_embedding_hyde
① 核心功能说明
实现HyDE(Hypothetical Document Embeddings)策略:先让LLM根据用户问题生成一段"假设性答案",再将"用户问题+假设答案"合并后做向量检索。这种方法能大幅提升对"语义匹配但字面不匹配"问题的召回能力。
② 输入数据(本节点收到的)
{
    "rewritten_query": "str      // 改写后的用户问题",
    "item_names": "List[str]     // 已确认商品名列表"
}
③ 输出数据(本节点传出的)
{
    "hyde_embedding_chunks": "List   // 检索到的切片列表(格式同普通向量检索)",
    "hyde_doc": "str                 // LLM生成的假设性文档"
}
④ 核心业务规则
▸ 步骤1:生成假设性文档
Prompt:
请基于以下用户查询生成一个简洁的回答范文。
用户查询: {rewritten_query}
要求:
1. 简洁明了,包含核心信息
2. 假设你是该领域专家,提供专业解释
3. 不要使用"假设"、"可能"等不确定词汇
4. 保持与查询主题高度相关
5. 中文回答且不超过300字
▸ 步骤2:拼接并检索
combined_text = rewritten_query + " " + hyde_doc  # 用户问题 + 假设答案
    ↓
generate_embeddings([combined_text])
    ↓
混合检索(参数同普通向量检索,limit=10)
    ↓
返回检索结果列表
HyDE核心优势:
| 对比项 | 直接搜索(无HyDE) | 使用HyDE |
|---|---|---|
| 语义丰富度 | 短查询语义稀疏 | 假设文档含专业词汇,语义饱满 |
| 匹配能力 | 仅匹配字面相似 | 桥接"问题"与"答案"语义鸿沟 |
| 召回率 | 低(尤其模糊查询) | 高(专业术语命中真实文档) |
⑤ 前置依赖
- 同普通向量检索(Milvus + BGE-M3)
- LLM服务可用(生成假设文档)
4.6 节点4:联网搜索节点(文档15)—— node_web_search_mcp
① 核心功能说明
调用百炼MCP(Model Context Protocol)联网搜索服务,获取互联网上的实时信息,作为知识库的补充。
② 输入数据(本节点收到的)
{
    "rewritten_query": "str   // 改写后的用户问题"
}
③ 输出数据(本节点传出的)
{
    "web_search_docs": [
        {
            "title": "str      // 结果标题",
            "url": "str        // 结果链接",
            "snippet": "str    // 核心摘要(非空)"
        }
    ]
}
④ 核心业务规则
MCP服务调用流程:
1. 创建MCP连接:MCPServerStreamableHttp(url, headers, timeout=10)
2. 连接服务:await search_mcp.connect()
3. 调用搜索工具:call_tool("bailian_web_search", {"query": query, "count": 5})
4. 解析响应:提取 type="tool_call" 的 content,解析 JSON pages 数组
5. 格式化:保留 title/url/snippet,清洗(去空格、过滤空snippet)
6. 资源清理:await search_mcp.cleanup()(无论成功/失败)
MCP调用参数:
| 参数 | 值 | 说明 |
|---|---|---|
tool_name | bailian_web_search | 百炼搜索工具固定标识 |
query | rewritten_query | 搜索查询词 |
count | 5 | 返回结果数量(1-10) |
timeout | 10秒 | HTTP连接超时 |
max_retry_attempts | 3 | 最大重试次数 |
响应解析路径:
MCP流式响应 → type="tool_call" → content[0].text → JSON对象 → pages数组
⑤ 前置依赖
- 阿里云百炼MCP服务已开通并配置
- API Key有效
MCP_DASHSCOPE_BASE_URL环境变量已配置
4.7 节点5:RRF融合排序节点(文档16)—— node_rrf
① 核心功能说明
将多路检索结果(向量检索 + HyDE检索)通过Reciprocal Rank Fusion(倒数排名融合)算法进行融合,生成统一的排序结果。多路投票系统解决不同来源分数不可比的问题。
② 输入数据(本节点收到的)
{
    "embedding_chunks": "list     // 普通向量检索结果",
    "hyde_embedding_chunks": "list  // HyDE检索结果"
}
③ 输出数据(本节点传出的)
{
    "rrf_chunks": "list  // RRF融合排序后的文档列表(已去重)"
}
④ 核心业务规则
RRF算法公式:
$$RRF_score(d) = \sum_{i=1}^{n} \frac{weight_i}{k + rank_i(d)}$$
参数说明:
| 参数 | 默认值 | 说明 |
|---|---|---|
k | 60 | 平滑常数,防止头部排名过度主导 |
weight | 1.0 | 各路权重(两路均等) |
各路段权重分配:
| 检索路 | 权重 | 说明 |
|---|---|---|
| 向量搜索 | 1.0 | 语义相似度检索 |
| HyDE搜索 | 1.0 | 假设文档增强检索 |
| ~~网络搜索~~ | - | Rerank节点再做合并 |
k=60的缓冲效果示例:
排名1: 1/(60+1) = 0.0164
排名2: 1/(60+2) = 0.0161 (仅下降1.8%)
排名10: 1/(60+10) = 0.0143 (下降13%)
k=60保证各路排名差距不会被放大,确保多路融合公平性。
算法实现逻辑:
1. 遍历各路输入,对每个文档计算 RRF 得分 = weight / (k + rank)
2. 相同 chunk_id 累加得分
3. 按得分降序排序
4. 返回排序后的文档列表(仅文档,不含分数)
⑤ 前置依赖
embedding_chunks和hyde_embedding_chunks至少一路有数据
4.8 节点6:Rerank重排序节点(文档17)—— node_rerank
① 核心功能说明
使用Cross-Encoder(BGE-Reranker-Large / qwen3-rerank)模型对RRF融合结果和网络搜索结果进行精排,并通过断崖检测算法实现动态TopK截断。精排阶段能准确判断文档是否真正回答了用户问题。
② 输入数据(本节点收到的)
{
    "rewritten_query": "str     // 改写后的用户问题",
    "rrf_chunks": "list         // RRF融合排序后的本地文档",
    "web_search_docs": "list    // 联网搜索结果"
}
③ 输出数据(本节点传出的)
{
    "reranked_docs": [
        {
            "content": "str           // 文档内容",
            "title": "str             // 文档标题",
            "chunk_id": "str/None     // 切片ID(本地文档有,网络文档为None)",
            "url": "str/None          // 来源URL(网络文档有,本地文档为None)",
            "source": "str            // 来源:'local'或'web'",
            "score": "float           // Reranker相关性评分"
        }
    ]
}
④ 核心业务规则
▸ 步骤1:合并多源文档
统一两种来源的文档格式:
| 字段 | 本地文档(rrf) | 网络文档(web) |
|---|---|---|
content | rrf_doc.content | web_doc.snippet |
title | rrf_doc.title | web_doc.title |
chunk_id | 有值 | None |
url | None | 有值 |
source | "local" | "web" |
▸ 步骤2:Rerank精排
Reranker模型参数:
| 参数 | 值 | 说明 |
|---|---|---|
| 模型 | qwen3-rerank | DashScope云端Rerank模型 |
| instruct | "针对给定的查询,检索能够解答该查询的相关段落" | 指令用于引导模型 |
Bi-Encoder vs Cross-Encoder对比:
| 特性 | Bi-Encoder(向量检索) | Cross-Encoder(Rerank) |
|---|---|---|
| 编码方式 | 问题/文档独立编码 | 问题+文档联合编码 |
| 速度 | 快(支持批量) | 慢(逐对评估) |
| 精度 | 中(语义近似) | 高(精确判断相关性) |
| 阶段 | 召回/粗排 | 精排 |
两阶段检索策略:
阶段1:Bi-Encoder(向量搜索+RRF)→ 100万→50篇候选(~10ms)
阶段2:Cross-Encoder(Rerank)→ 50篇精排打分(~500ms)
最终:取Top-K(3-10篇)
▸ 步骤3:断崖检测动态截断
全局常量:
| 常量 | 值 | 说明 |
|---|---|---|
RERANK_MAX_TOPK | 10 | 最多保留文档数 |
RERANK_MIN_TOPK | 3 | 最少保留文档数 |
RERANK_GAP_ABS | 0.5 | 绝对断崖阈值(高分区间) |
RERANK_GAP_RATIO | 0.25 | 相对断崖阈值(低分区间) |
断崖检测算法:
1. 遍历索引 i 从 min_topk-1 到 max_topk-2
2. 计算相邻得分差:abs_gap = score[i] - score[i+1]
3. 计算相对下降比例:rel_gap = abs_gap / |score[i]|
4. 触发条件:abs_gap >= 0.5 或 rel_gap >= 0.25
5. 截断位置:前 i+1 条
断崖检测示例:
得分: [0.95, 0.92, 0.88, 0.12, 0.08]
差值:      0.03   0.04   0.76   0.04
                         ↑ 断崖!截断在位置3
结果: 保留前3篇
为什么需要两个阈值?
- 高分区间(0.95→0.40):
abs_gap=0.55 > 0.5触发绝对阈值 - 低分区间(0.30→0.08):
abs_gap=0.22 < 0.5但rel_gap=0.73 > 0.25触发相对阈值
⑤ 前置依赖
- RRF结果(
rrf_chunks)至少有一条 - 网络搜索可能有结果(
web_search_docs) - Reranker模型可用
4.9 节点7:答案输出节点(文档20)—— node_answer_output
① 核心功能说明
检索管线的终点。根据state中的已有答案或拼接的Prompt调用LLM生成最终回答,支持流式/非流式输出,将答案写入MongoDB历史记录,提取文档中的图片URL下发给前端。
② 输入数据(本节点收到的)
{
    "session_id": "str           // 会话ID",
    "original_query": "str       // 用户原始问题",
    "rewritten_query": "str      // 改写后的问题",
    "item_names": "List[str]     // 商品名称列表",
    "history": "list             // 历史对话",
    "reranked_docs": "list       // 重排序后的文档",
    "is_stream": "bool           // 是否流式输出",
    "answer": "str/None          // 已有答案(来自产品确认节点的反问/拒绝)"
}
③ 输出数据(本节点传出的)
{
    "prompt": "str       // 组装后的完整提示词",
    "answer": "str       // LLM生成的最终答案",
    (同时通过SSE推送/写入MongoDB)
}
④ 核心业务规则与处理流程
▸ 阶段一:检查已有答案
- 如果
state["answer"]已存在(来自产品确认节点的反问/拒绝):- 流式模式:推送
SSEEvent.DELTA事件 - 非流式模式:直接设置
task_result - 返回True,跳过后续生成
- 流式模式:推送
▸ 阶段二:构建Prompt
字符预算控制: MAX_CONTEXT_CHARS = 12000
Prompt组装过程:
1. 获取问题和商品名
   question = rewritten_query ?? original_query
   item_names_str = join(item_names)

2. 格式化重排序文档(带字符预算控制)
   每条文档格式:[序号][source=xxx][chunk_id=xxx][url=xxx][title=xxx][score=0.xxxx] 内容
   累加字符,超过 MAX_CONTEXT_CHARS 则停止添加

3. 格式化历史对话
   "用户: xxx\n助手: xxx" 格式,同样受字符预算约束

4. 组装最终Prompt
答案生成提示词(ANSWER_PROMPT):
你是一个智能助手,请根据参考内容回答用户的问题。
要求:
1 尽量基于【参考内容】和【用户问题】作答,不要编造不存在的事实。
2 如果用户的问题需要通过图片来辅助说明,请在答案最后追加图片区块。
  格式:【图片】\n<URL1>\n<URL2>(每行一个URL)

【参考内容】{context}
【历史对话】{history}
【相关商品/实体】{item_names}
【用户问题】{question}
▸ 阶段三:生成回答
流式模式(is_stream=True):
llm.stream(prompt) → 逐chunk获取delta内容
    ↓
push_to_session(session_id, SSEEvent.DELTA, {"delta": delta})
    ↓
累加至 final_text → state["answer"] = final_text
非流式模式(is_stream=False):
llm.invoke(prompt) → response.content
    ↓
state["answer"] = content
set_task_result(session_id, "answer", content)
▸ 提取图片URL(双保险机制)
代码从源文档中直接提取图片链接,而非依赖大模型生成的【图片】区块:
| 提取策略 | 来源 | 匹配方式 |
|---|---|---|
| 策略一 | 文档 url 字段 | 检查后缀是否为图片格式(png/jpg/gif/webp等) |
| 策略二 | 文档 content 正文 | 正则 !\[.*?\]\((.*?)\) 提取Markdown图片URL |
为什么不用大模型生成的图片区块?
- 大模型可能编造URL或格式错误
- 源数据最准确(直接从reranked_docs提取)
▸ 阶段四:写入MongoDB历史
- 保存
role="assistant"的消息 - 包含
answer,item_names,image_urls - 写历史失败不影响主链路
▸ 阶段五:发送final事件
- 仅在流式模式下执行
- 推送内容:
{answer, status="completed", image_urls} - 目的:触发前端图片渲染
⑤ 前置依赖
- 重排序结果(
reranked_docs)已就绪 - LLM服务可用
- MongoDB可用(历史记录存储)
⑥ 持久化存储
| 存储位置 | 集合 | 存储内容 |
|---|---|---|
| MongoDB | chat_message | 最终回答记录(含图片URL) |
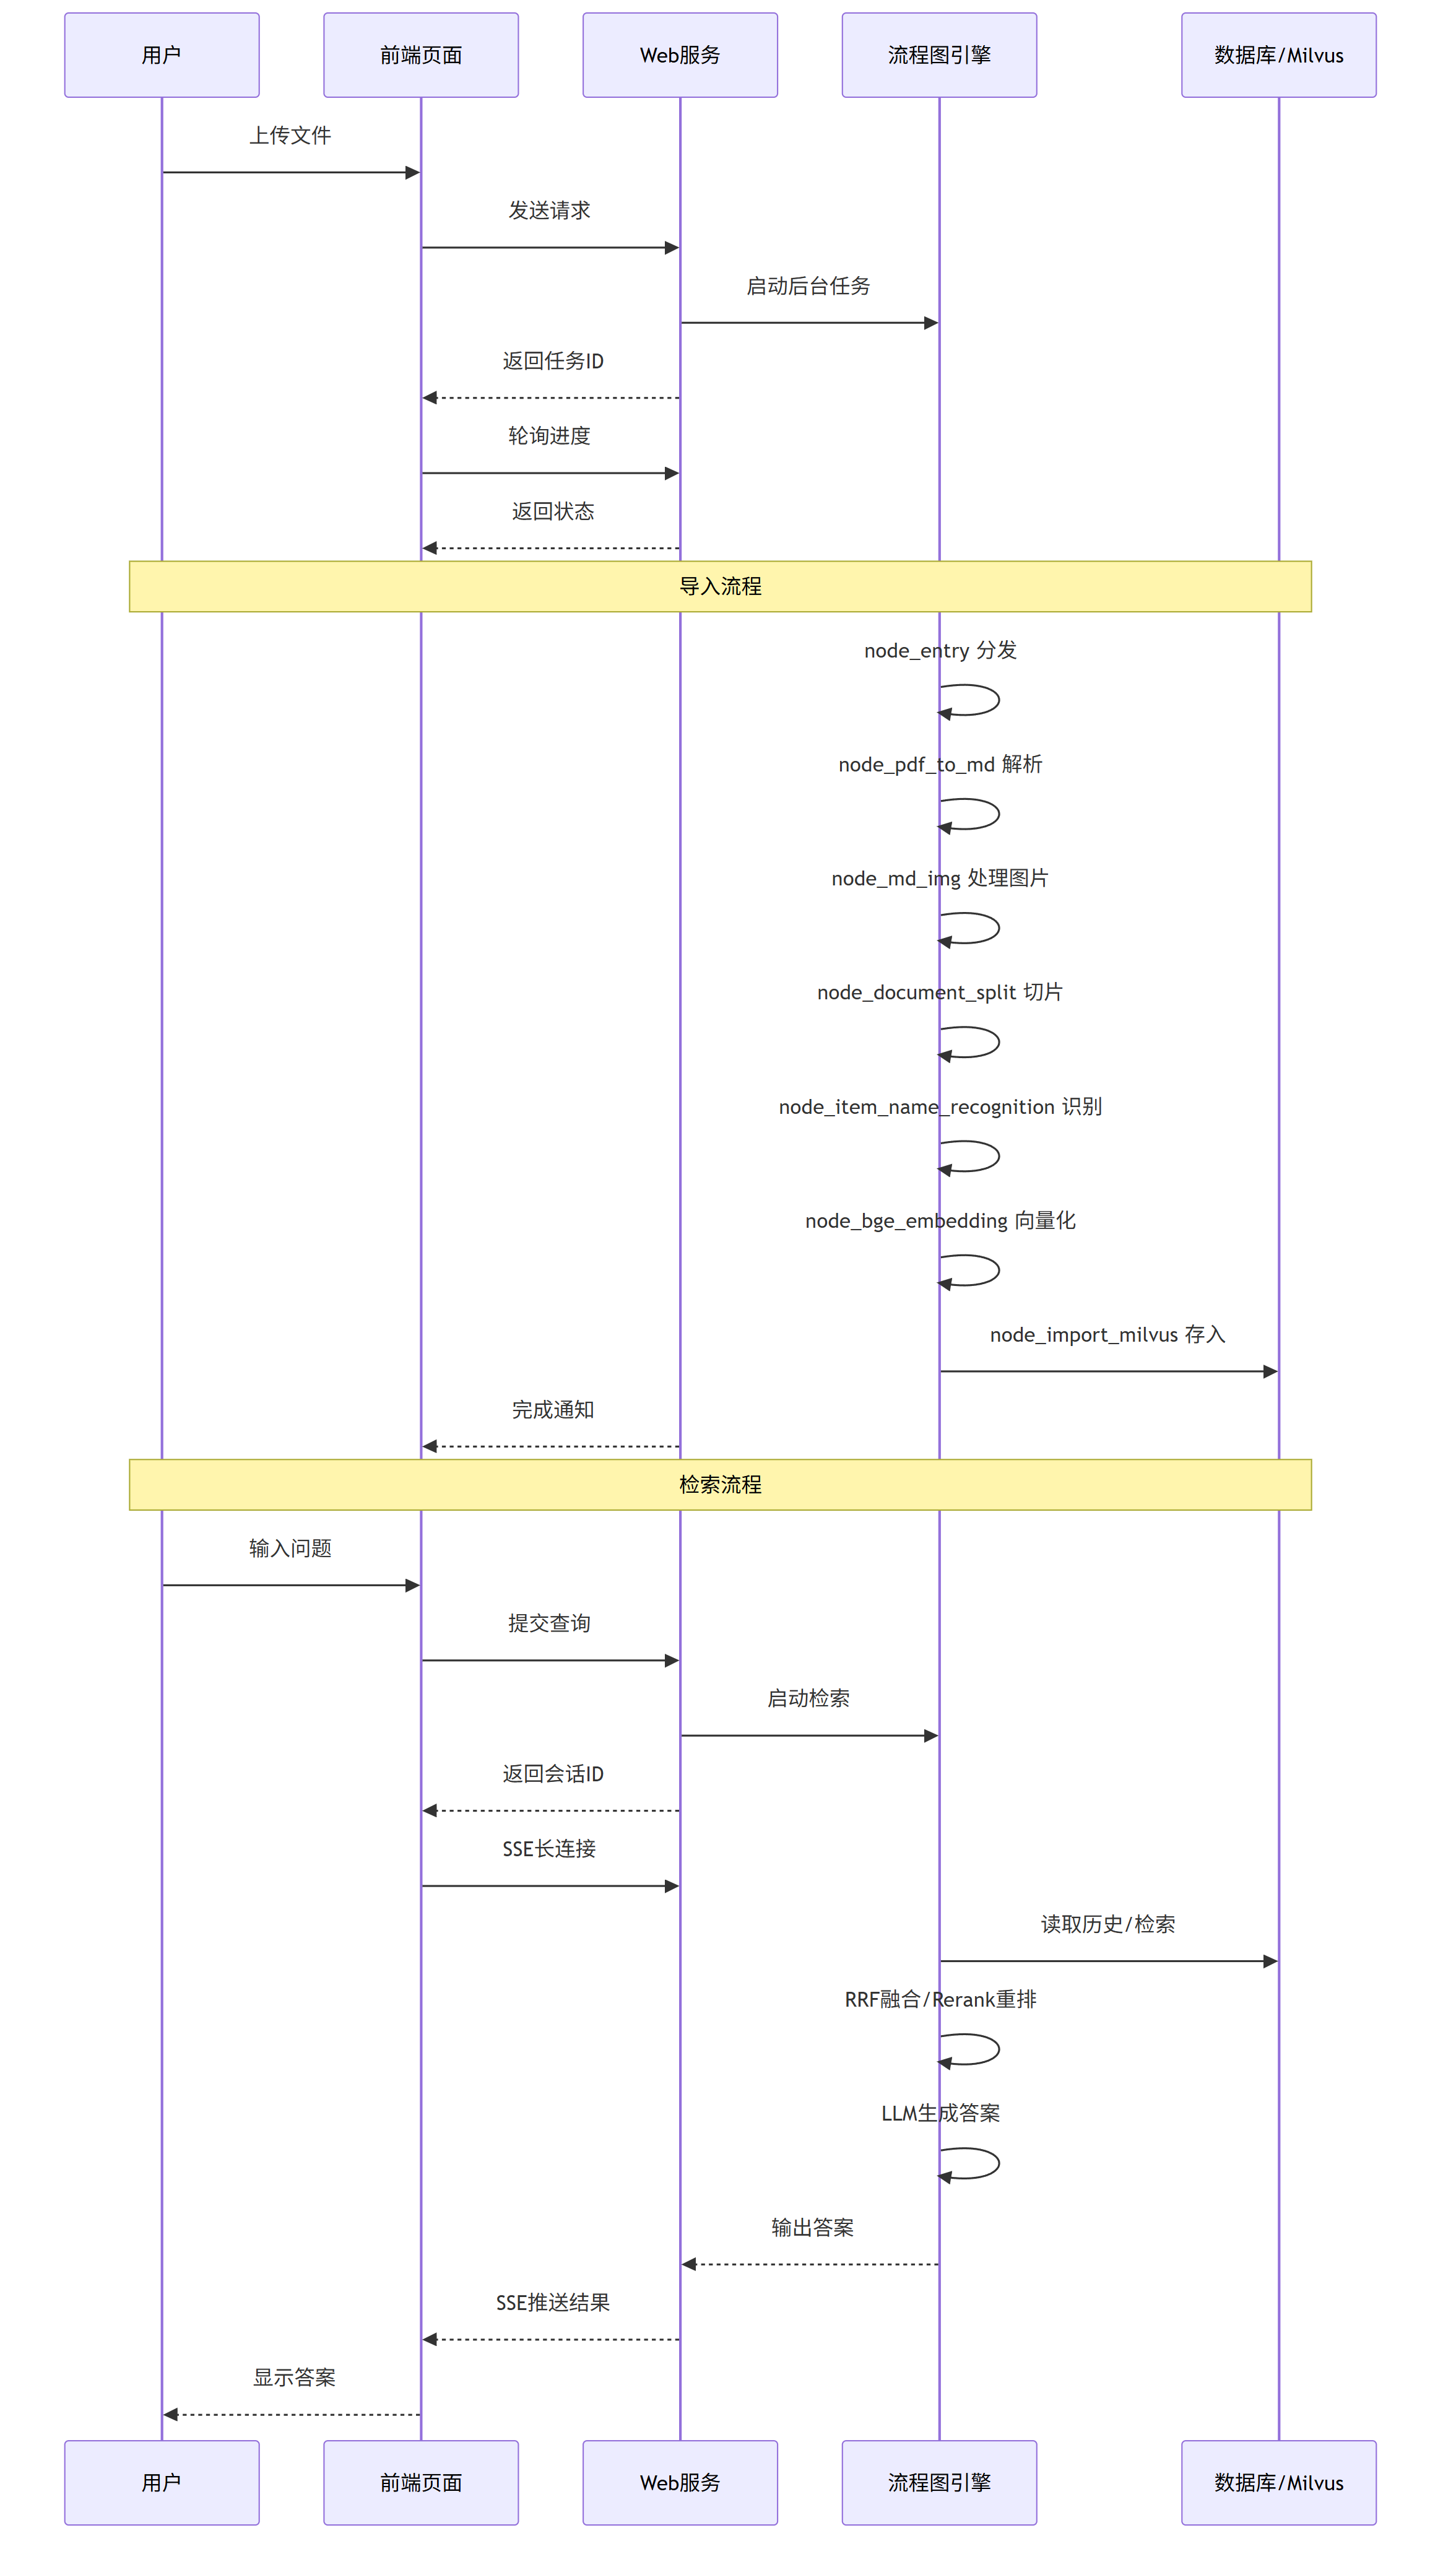
5. Web服务、API接口与前端交互逻辑
5.1 服务架构概览
本系统提供两个独立部署的Web服务:
| 服务 | 端口 | 功能 | 对应文档 |
|---|---|---|---|
导入服务 (import_service.py) | 8000 | 文件上传→知识库构建 | 18, 19 |
查询服务 (query_service.py) | 8001 | 会话问答→流式输出 | 18, 19 |
5.2 导入服务 API 接口
5.2.1 接口清单
| 接口 | 方法 | 路径 | 功能 |
|---|---|---|---|
| 文件上传 | POST | /upload | 支持多文件上传,触发LangGraph导入流程 |
| 状态查询 | GET | /status/{task_id} | 前端轮询获取任务处理进度 |
| 前端页面 | GET | /import.html | 返回文件导入页面 |
5.2.2 文件上传接口(/upload)
请求格式:
form-data,字段名files,支持多文件
处理流程:
1. 生成UUID作为task_id
2. 按日期分层保存到本地:{DATA_BASED_ROOT_DIR}/YYYYMMDD/{task_id}/{文件名}
3. 上传到MinIO:pdf_files/YYYYMMDD/{文件名}
4. 启动后台任务:run_graph_task(task_id, file_dir, import_file_path)
5. 返回所有task_ids列表
后台任务(run_graph_task)执行流程:
1. update_task_status(task_id, "processing")
2. KBImportWorkflow().run(init_state, stream=True)
3. 每完成一个节点,add_done_task(task_id, node_name)
4. 全部完成 → update_task_status(task_id, "completed")
5. 异常 → update_task_status(task_id, "failed")
5.2.3 状态查询接口(/status/{task_id})
返回数据:
{
    "code": 200,
    "task_id": "str",
    "status": "str           // pending/processing/completed/failed",
    "done_list": "List[str]  // 已完成的节点列表",
    "running_list": "List[str]  // 正在运行的节点列表"
}
5.2.4 前端页面功能
- 文件拖拽/选择(支持PDF/MD)
- 上传进度条
- 状态轮询(
setInterval每2秒一次) - 日志展示(根据
done_list和running_list动态渲染)
5.3 查询服务 API 接口
5.3.1 接口清单
| 接口 | 方法 | 路径 | 功能 |
|---|---|---|---|
| 提问 | POST | /query | 接收用户问题,触发检索流程 |
| 流式推送 | GET | /stream/{session_id} | SSE长连接,实时推送进度和答案 |
| 历史查询 | GET | /history/{session_id} | 获取会话历史记录 |
| 清空历史 | DELETE | /history/{session_id} | 删除会话所有记录 |
| 健康检查 | GET | /health | 服务存活检测 |
| 前端页面 | GET | /chat.html | 返回聊天对话页面 |
5.3.2 查询接口(/query)
请求体(Pydantic模型):
{
    "query": "str       // 用户问题(必填)",
    "session_id": "str  // 会话ID(可选,未传自动生成)",
    "is_stream": "bool  // 是否流式输出(默认false)"
}
流式响应流程(is_stream=true):
1. 创建SSE队列:create_sse_queue(session_id)
2. 异步提交后台任务:run_query_graph(session_id, query, is_stream=true)
3. 立即返回:{message, session_id}
4. 后台执行时,通过SSE推送以下事件:
   - ready: 握手成功
   - progress: 节点执行进度(done_list / running_list)
   - delta: 答案增量字符(逐字输出)
   - final: 完整答案 + 图片URL列表
   - error: 异常信息
SSE推送数据格式:
| 事件类型 | 数据内容 |
|---|---|
progress | {"done_list": ["节点A",...], "running_list": ["节点B",...]} |
delta | {"delta": "生成的增量字符"} |
final | {"answer": "完整答案", "status": "completed", "image_urls": [...]} |
error | {"error": "错误详情"} |
非流式响应(is_stream=false):
{
    "message": "处理完成!",
    "session_id": "xxx",
    "answer": "回答内容...",
    "done_list": []
}
5.3.3 任务状态管理与SSE推送机制
核心组件:
task_utils.py:内存中的任务状态管理(状态字典 + 完成列表 + 运行列表)sse_utils.py:SSE队列管理 + 事件推送
任务状态流转:
pending → processing → completed / failed
SSE推送触发时机:
- 每个检索节点执行前:
add_running_task→ 自动推送progress事件 - 每个检索节点执行后:
add_done_task→ 自动推送progress事件 - 答案生成时:
push_to_session(SSEEvent.DELTA)→ 逐字推送 - 全部完成:
push_to_session(SSEEvent.FINAL)→ 最终推送
5.4 SSE技术实现
SSE协议格式:
event: 事件名\ndata: JSON数据\n\n
FastAPI实现要点:
StreamingResponse(generator, media_type="text/event-stream")- 跨域:
CORSMiddleware(allow_origins=["*"]) - 异步队列:
asyncio.Queue实现生产者-消费者模式
6. 全局通用公共数据结构汇总
6.1 持久化存储数据
6.1.1 Milvus kb_chunks 集合(知识库切片)
| 字段 | 类型 | 说明 | 来源节点 |
|---|---|---|---|
chunk_id | INT64 (PK, auto_id) | 切片自增主键ID | 自动生成 |
content | VARCHAR(65535) | 切片文本内容 | 切片节点 |
title | VARCHAR(100) | 切片标题 | 切片节点 |
parent_title | VARCHAR(100) | 父级标题 | 切片节点 |
part | INT8 | 分片编号 | 切片节点 |
file_title | VARCHAR(100) | 源文件标题 | 入口节点 |
item_name | VARCHAR(100) | 商品名称 | 主体识别节点 |
dense_vector | FLOAT_VECTOR(dim) | BGE-M3稠密向量 | 向量化节点 |
sparse_vector | SPARSE_FLOAT_VECTOR | BGE-M3稀疏向量 | 向量化节点 |
6.1.2 Milvus kb_item_names 集合(商品名称)
| 字段 | 类型 | 说明 | 来源节点 |
|---|---|---|---|
pk | INT64 (PK, auto_id) | 自增主键 | 自动生成 |
file_title | VARCHAR(100) | 文件标题 | 入口节点 |
item_name | VARCHAR(100) | 商品名称 | 主体识别节点 |
dense_vector | FLOAT_VECTOR(1024) | 商品名稠密向量 | 主体识别节点 |
sparse_vector | SPARSE_FLOAT_VECTOR | 商品名稀疏向量 | 主体识别节点 |
6.1.3 MongoDB chat_message 集合(对话历史)
| 字段 | 类型 | 说明 |
|---|---|---|
_id | ObjectId | MongoDB默认主键 |
session_id | string | 会话唯一标识 |
role | string | 消息角色:user/assistant |
text | string | 对话文本内容 |
rewritten_query | string | 改写后的完整问题(用户消息关联) |
item_names | array[string] | 关联的商品名称列表 |
image_urls | array[string] | 关联的图片URL列表 |
ts | number | 时间戳(秒级) |
6.1.4 MinIO 对象存储
| 目录 | 存储内容 | 权限 |
|---|---|---|
knowledge-base/pdf_files/YYYYMMDD/ | 上传的原始PDF文件 | Private |
knowledge-base/upload-images/{doc_stem}/ | 文档中的图片文件 | Public Read |
6.2 内存流转临时数据
6.2.1 导入管线状态(ImportGraphState)
| 字段 | 类型 | 说明 | 生命周期 |
|---|---|---|---|
task_id | str | 任务追踪ID | 全流程 |
import_file_path | str | 原始输入文件路径 | 入口阶段 |
file_dir | str | 输出目录 | 全流程 |
file_title | str | 文件标题 | 全流程 |
is_pdf_read_enabled | bool | PDF标志 | 路由阶段 |
is_md_read_enabled | bool | MD标志 | 路由阶段 |
pdf_path | str | PDF文件路径 | PDF→MD阶段 |
md_path | str | Markdown文件路径 | 图片处理→切片阶段 |
md_content | str | Markdown内容 | 图片处理→切片阶段 |
chunks | List | 切片列表(含向量) | 切片→持久化阶段 |
item_name | str | 识别出的商品名称 | 主体识别→持久化阶段 |
6.2.2 检索管线状态(QueryGraphState)
| 字段 | 类型 | 说明 | 生命周期 |
|---|---|---|---|
session_id | str | 会话ID | 全流程 |
original_query | str | 用户原始问题 | 全流程 |
rewritten_query | str | 改写后的问题 | 产品确认后→答案生成 |
item_names | List[str] | 提取出的商品名称 | 产品确认→答案生成 |
history | list | 历史对话记录 | 产品确认→答案生成 |
embedding_chunks | list | 向量检索切片 | 检索→RRF |
hyde_embedding_chunks | list | HyDE检索切片 | HyDE检索→RRF |
web_search_docs | list | 网络搜索结果 | 联网搜索→Rerank |
rrf_chunks | list | RRF融合结果 | RRF→Rerank |
reranked_docs | list | 重排序最终结果 | Rerank→答案生成 |
prompt | str | 组装好的Prompt | 答案生成阶段 |
answer | str | 最终答案 | 答案生成→END |
is_stream | bool | 是否流式输出 | 全流程 |
7. 项目完整数据流Mermaid流程图
7.1 离线导入管线数据流图
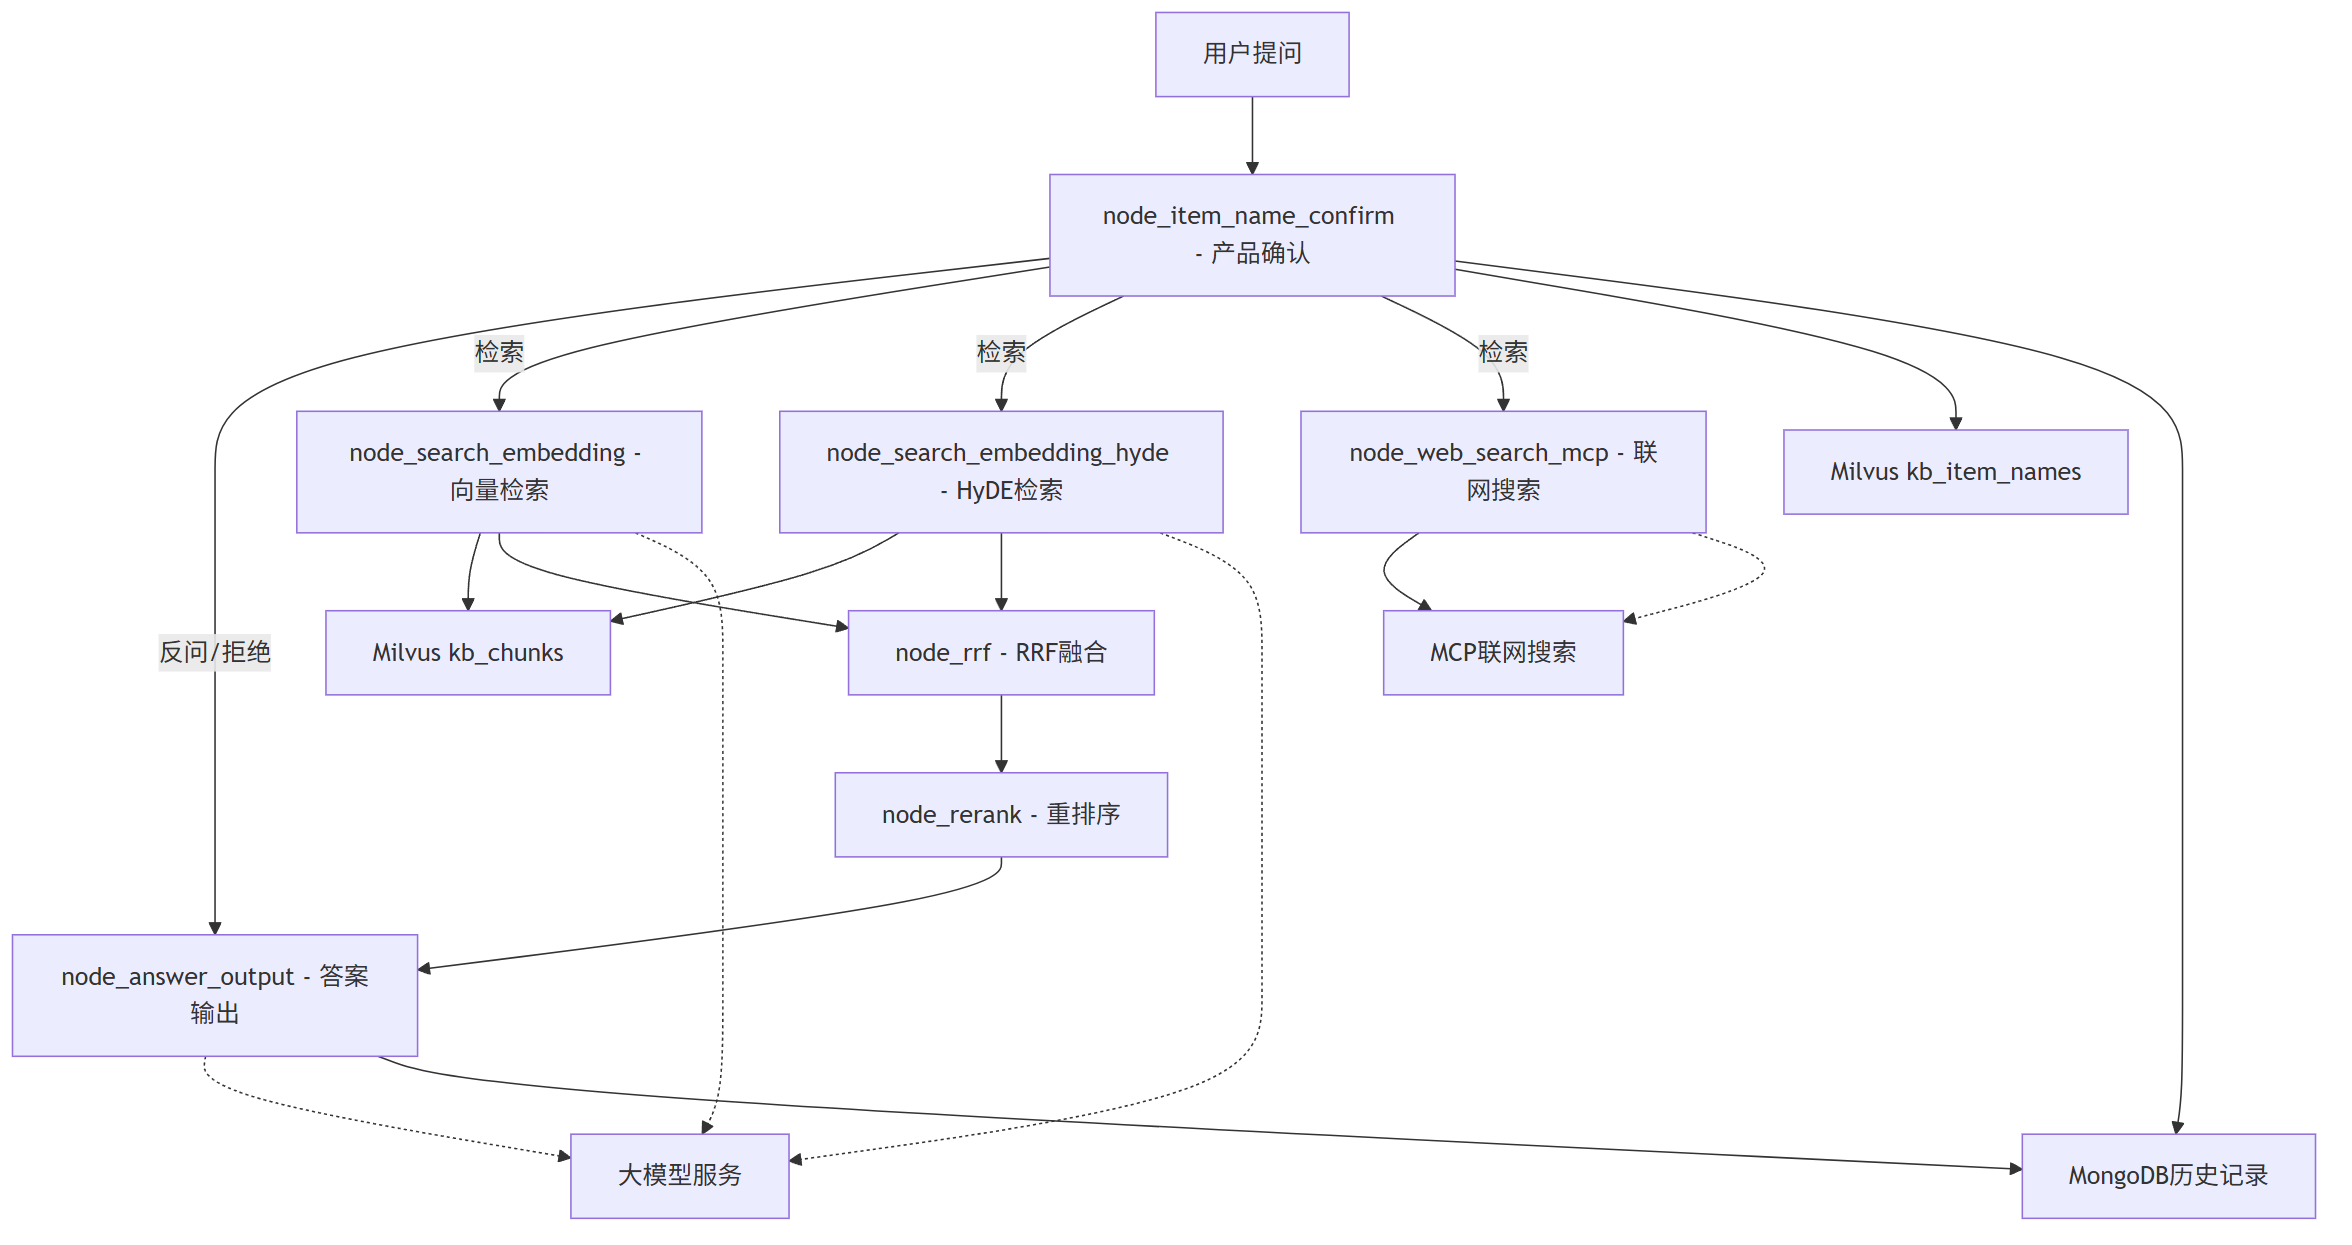
7.2 在线检索管线数据流图
7.3 Web服务与前端交互全景图
7.4 数据在管线节点间的流转对照表
7.4.1 导入管线数据流转
输入文件 → [node_entry] → md_content → [node_md_img] → md_content → [node_document_split]
    → chunks → [node_item_name_recognition] → chunks(item_name回填) → [node_bge_embedding]
    → chunks(含向量) → [node_import_milvus] → Milvus持久化

路径信息(file_title/pdf_path/md_path) 贯穿全流程
商品名称(item_name) 从主体识别节点开始传递
7.4.2 检索管线数据流转
original_query → [node_item_name_confirm]
    → rewritten_query + item_names → [node_search_embedding] → embedding_chunks
    → rewritten_query + item_names → [node_search_embedding_hyde] → hyde_embedding_chunks + hyde_doc
    → rewritten_query → [node_web_search_mcp] → web_search_docs

embedding_chunks + hyde_embedding_chunks → [node_rrf] → rrf_chunks
rrf_chunks + web_search_docs → [node_rerank] → reranked_docs
reranked_docs → [node_answer_output] → answer + MongoDB历史
附录:关键参数速查表
导入流程参数
| 参数 | 所在节点 | 默认值 | 说明 |
|---|---|---|---|
max_content_length | document_split | 2000 | 切片最大字符数 |
min_content_length | document_split | 500 | 合并短内容最小长度 |
overlap_sentences | document_split | 1 | 句子级切分重叠句数 |
item_name_chunk_k | item_name_recognition | 3 | 商品名识别切片数 |
item_name_chunk_size | item_name_recognition | 2500 | 商品名识别上下文长度 |
embedding_batch_size | bge_embedding | 5 | 向量化批次大小 |
image_extensions | md_img | {.jpg,.jpeg,.png,.gif,.bmp,.webp} | 支持的图片格式 |
requests_per_minute | md_img | 15 | 图片总结API限流 |
Milvus索引参数
| 集合 | 字段 | 索引类型 | 度量方式 | 额外参数 |
|---|---|---|---|---|
kb_chunks | dense_vector | AUTOINDEX | COSINE | - |
kb_chunks | sparse_vector | SPARSE_INVERTED_INDEX | IP | DAAT_MAXSCORE, normalize=True |
kb_item_names | dense_vector | IVF_FLAT | COSINE | nlist=128 |
kb_item_names | sparse_vector | SPARSE_INVERTED_INDEX | IP | DAAT_MAXSCORE, normalize=True |
检索流程参数
| 参数 | 所在节点 | 默认值 | 说明 |
|---|---|---|---|
| 稠密/稀疏权重 | search_embedding | 0.8/0.2 | 混合检索权重配比 |
| 底层检索数(limit) | search_embedding/hyDE | 10 | 预留额外结果供RRF |
| RRF常数k | rrf | 60 | 平滑常数 |
| RRF权重 | rrf | (1.0, 1.0) | 两路均等 |
| RERANK_MAX_TOPK | rerank | 10 | 重排序最多保留数 |
| RERANK_MIN_TOPK | rerank | 3 | 重排序最少保留数 |
| RERANK_GAP_ABS | rerank | 0.5 | 断崖检测绝对阈值 |
| RERANK_GAP_RATIO | rerank | 0.25 | 断崖检测相对阈值 |
| MAX_CONTEXT_CHARS | answer_output | 12000 | Prompt字符预算上限 |
| 商品名对齐高分阈值 | item_name_confirm | 0.85 | 确信匹配分界线 |
| 商品名对齐候选阈值 | item_name_confirm | 0.6 | 疑似候选分界线 |
| 历史记录查询条数 | item_name_confirm | 10 | 最近N条对话记录 |